《人工智能核心方法演进:从统计学习到生成式大模型》
第 5 篇:深度学习工程方法——数据增强、归一化、初始化与正则化
一、“技巧”这个词,掩盖了它们真正解决的问题
第 4 篇讲的是反向传播的数学形式:梯度如何通过链式法则从输出层逐层回传到输入层。但这个数学形式成立的前提,在真实训练中经常被破坏——激活值的分布随训练漂移、初始化的尺度让梯度在第一步就消失或爆炸、模型容量过大导致记忆训练集而非学习规律。这些不是“调参技巧”层面的问题,而是深度网络能否在有限时间和有限数据上收敛的方法论前提。
第 0 篇的三条路线,在预训练和对齐阶段全部依赖这些工程方法。DeepSeek-V3 用 FP8 混合精度训练 671B 参数的 MoE,如果没有数值稳定的归一化和初始化,训练在第一步就会发散;Anthropic 的 Constitutional AI 在 23000 词的宪法上做多阶段训练,如果没有正则化和早停,模型会在 SFT 数据上过拟合而非学会原则;OpenAI 的分层路由如果初始化不当,路由器会在训练早期坍缩到只选某一个专家——这些失败模式都不是理论层面的,而是工程层面的,而工程层面的失败会直接让理论层面的方法无法落地。
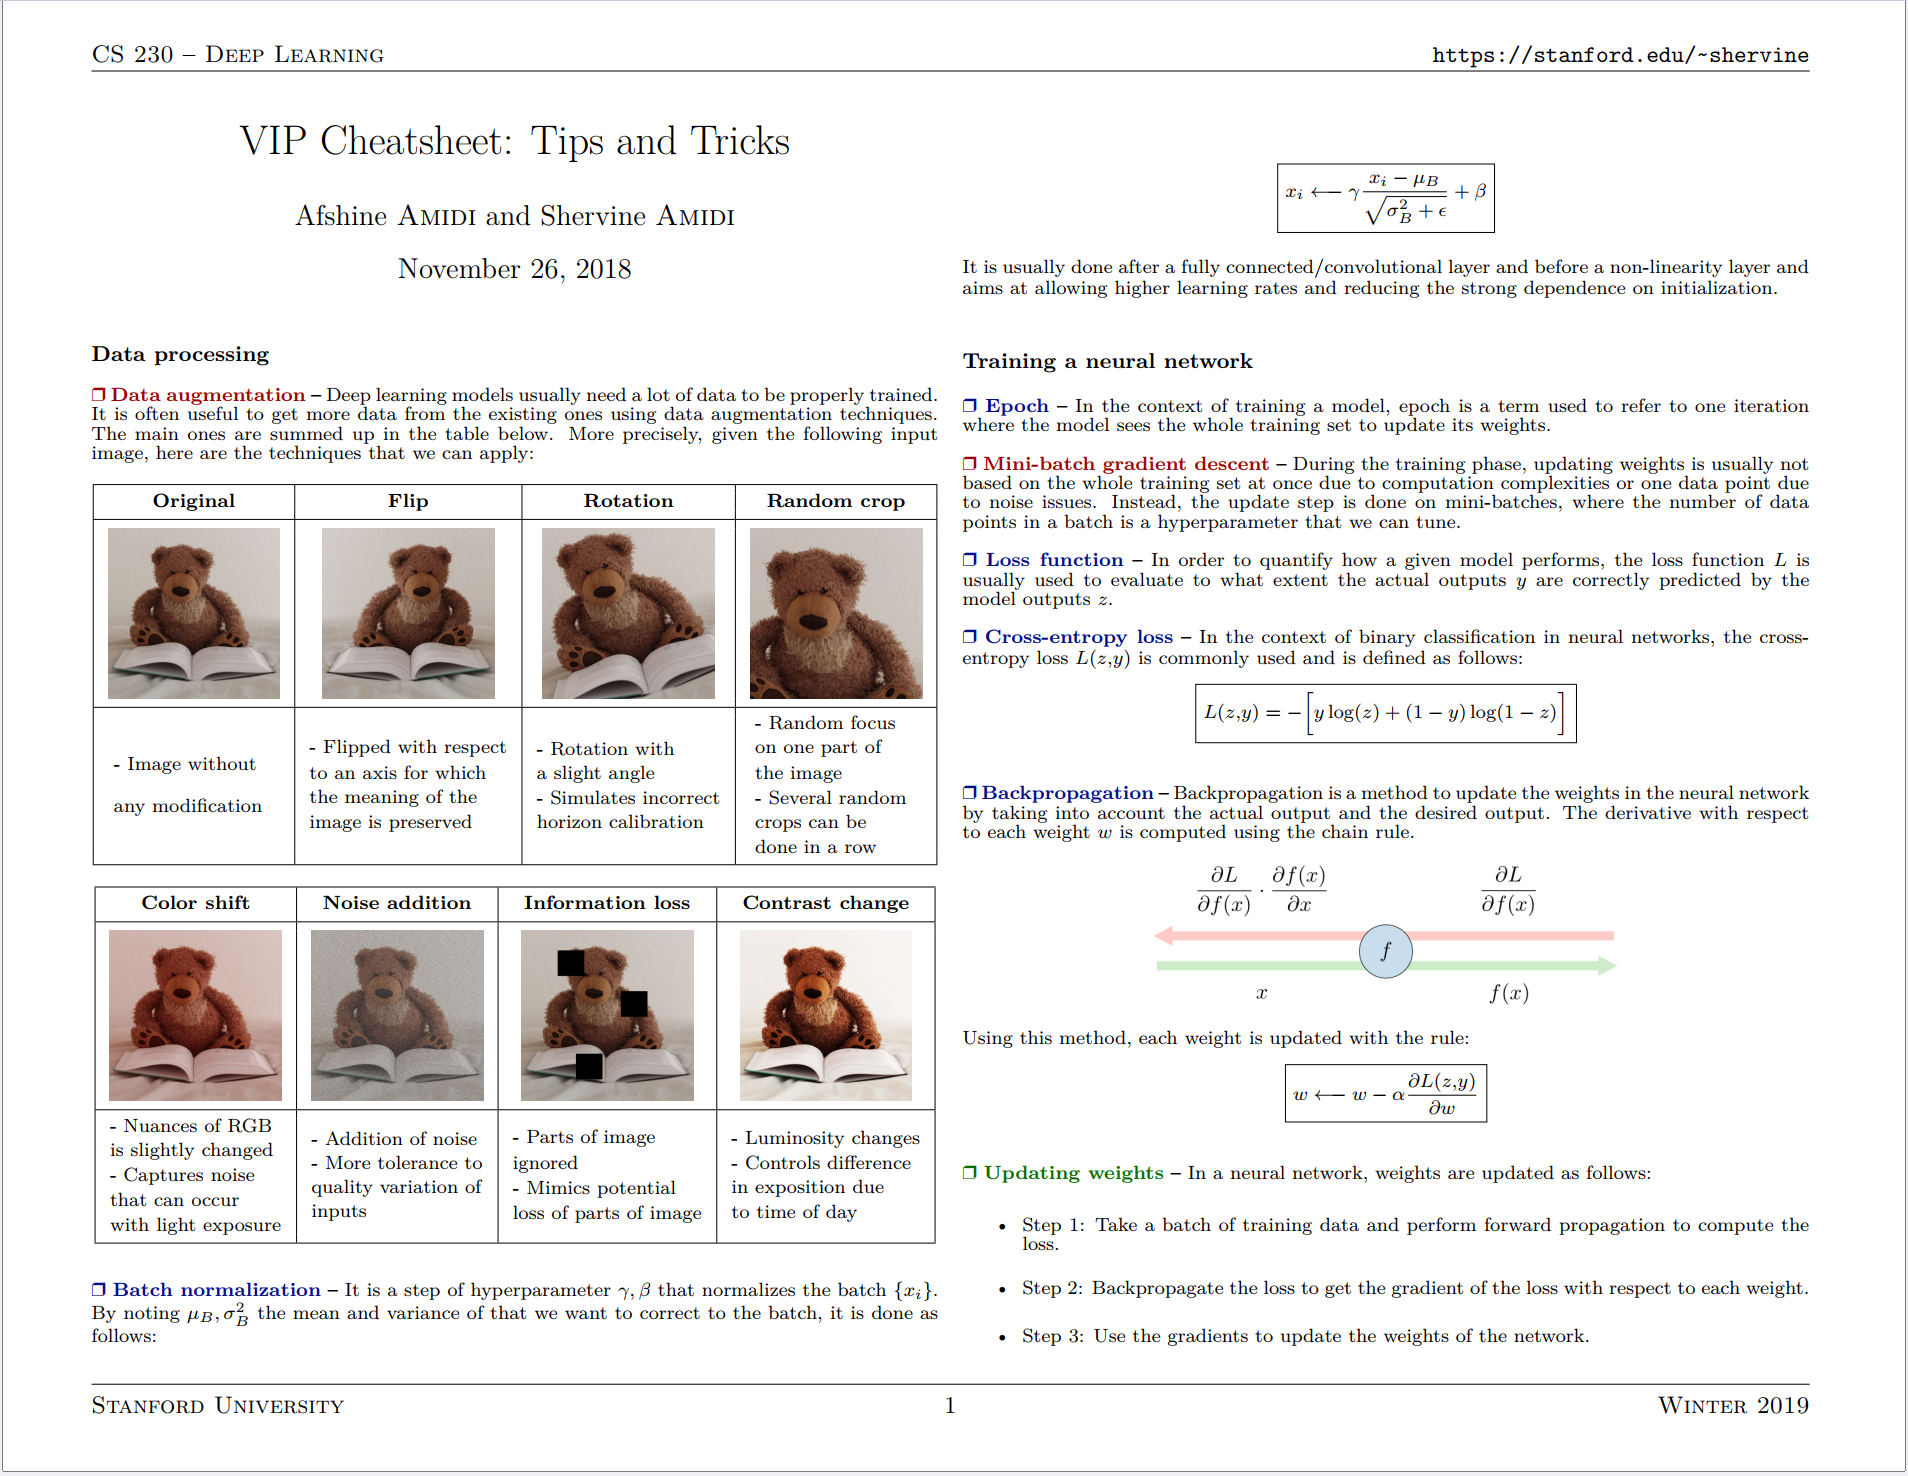
二、数据增强:把先验知识注入训练过程
数据增强的本质是在不增加参数的情况下,用已知的不变性假设缩小模型需要搜索的函数空间。一张图像水平翻转后,如果标签仍然是“猫”,那么模型就不需要学习“朝向”这个无关变量。这等价于一种隐式的正则化:它降低了方差,因为模型不再需要从有限数据中拟合那些本应被忽略的变化。
从概率统计的视角看,数据增强是在扩大经验分布的支持集。原始训练数据是从真实分布 (p_{\text{data}}) 中采样的有限样本,数据增强通过施加保持标签不变的变换 (T),生成新的样本 (T(x)),这些新样本近似服从同一个条件分布 (p(y \mid T(x)) = p(y \mid x))。这个等式是数据增强有效性的前提——如果变换改变了标签(比如把“6”旋转 180 度变成“9”),增强就引入了错误信号。
常见的图像增强包括翻转、随机裁剪、旋转、颜色抖动、噪声注入、对比度变化。它们各自对应不同的不变性假设:翻转对应“左右朝向不重要”,裁剪对应“物体位置可以变化”,颜色抖动对应“光照条件可以变化”。这些假设本身就是先验知识,数据增强是把这些先验从人类知识转移到训练过程中的一种方式。
在大模型语境下,数据增强的形式发生了变化,但逻辑没有变。文本的随机掩码(第 3.5 篇的 MLM)、同义词替换、回译(翻译成另一种语言再翻回来)都是保持语义不变的数据增强。DeepSeek-R1 的冷启动 SFT 数据筛选,本质上是数据增强的反面:不是扩大支持集,而是压缩支持集,只保留高质量、推理链完整的样本。两种操作的目标相同——让训练分布更接近目标分布。
三、批归一化:稳定激活分布,让深层网络可训练
第 4 篇提到梯度消失的一个原因是 Sigmoid 的饱和区——当输入绝对值较大时,导数趋近于零。但即使使用 ReLU,如果每一层的输入分布随训练漂移,后续层就需要不断适应新的输入尺度,训练会变得极其困难。Batch Normalization(BatchNorm)的核心操作,是对每一层的输入做标准化,使激活值的均值接近 0、方差接近 1:
xi←γxi−μBσB2+ϵ+β x_i \leftarrow \gamma \frac{x_i - \mu_B}{\sqrt{\sigma_B^2 + \epsilon}} + \beta xi←γσB2+ϵxi−μB+β
其中 (\mu_B) 和 (\sigma_B^2) 是当前 mini-batch 的均值和方差,(\gamma) 和 (\beta) 是可学习的缩放和平移参数。注意这里有一个容易被忽略的细节:如果只做标准化而不加 (\gamma) 和 (\beta),那么模型的表达能力会被限制在均值为 0、方差为 1 的分布上。(\gamma) 和 (\beta) 的作用是让模型自己决定“是否需要恢复原来的分布”——标准化的目的是稳定训练,而不是强制限制表示。
BatchNorm 通常放在全连接层或卷积层之后、非线性激活之前。它带来的工程收益包括:允许更高的学习率(因为激活值的尺度被归一化了)、降低对初始化的敏感性(因为每一层的输入分布被显式控制)、加速收敛。
但 BatchNorm 在序列模型和大模型中有两个重要的局限。第一,它的统计量依赖 batch 的组成,在推理时使用训练阶段的移动平均,如果训练和推理的数据分布差异较大,会出现不一致。第二,在 Transformer 中,BatchNorm 逐渐被 LayerNorm 取代,因为 LayerNorm 对每个样本独立计算均值和方差,不依赖 batch 的组成,更适合变长序列和自回归生成。GPT、DeepSeek、Claude 的 Transformer 层使用的都是 LayerNorm 或其变体(如 RMSNorm),而不是 BatchNorm——这个选择本身就是“序列模型不能依赖 batch 统计量”这一工程约束的体现。
四、初始化:让梯度在第一步就有合理的尺度
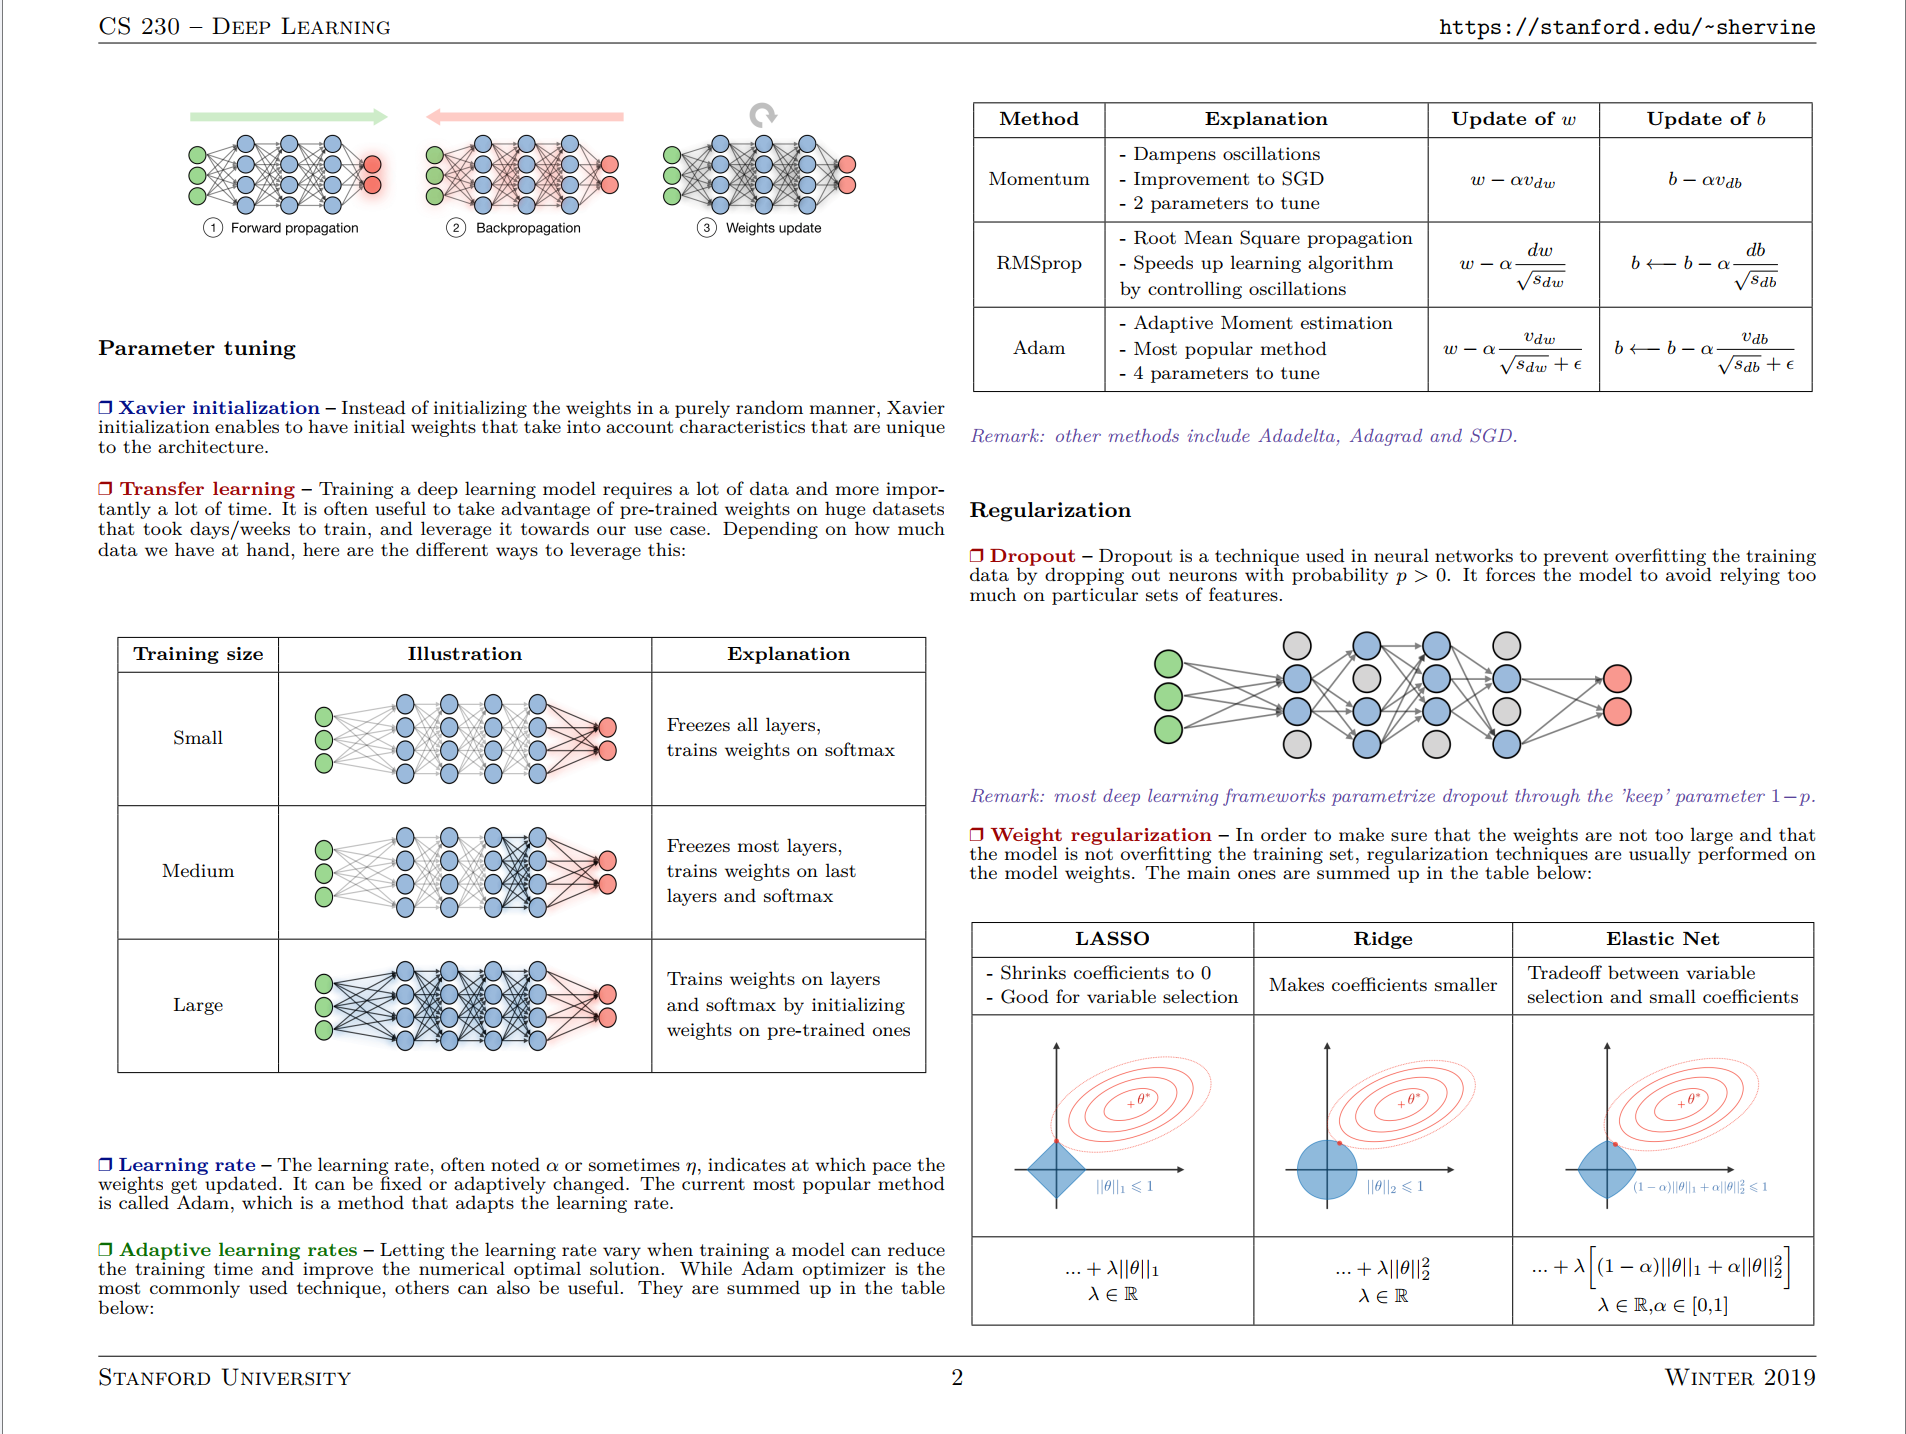
第 4 篇的梯度消失分析有一个隐含前提:权重矩阵的初始尺度是合理的。如果所有权重都初始化为很小的值(比如 0.01),那么每一层的激活值会逐层缩小,梯度也会逐层缩小;如果初始化为很大的值,激活值会逐层放大,梯度爆炸。初始化的目标是让每一层的激活值和梯度的方差在传播过程中保持稳定。
Xavier 初始化(Glorot 初始化)针对 tanh/sigmoid 激活函数设计,让每一层的输入和输出方差保持一致:
W∼N(0,1nin)或W∼N(0,2nin+nout) W \sim \mathcal{N}\left(0, \frac{1}{n_{\text{in}}}\right) \quad \text{或} \quad W \sim \mathcal{N}\left(0, \frac{2}{n_{\text{in}} + n_{\text{out}}}\right) W∼N(0,nin1)或W∼N(0,nin+nout2)
其中 (n_{\text{in}}) 和 (n_{\text{out}}) 分别是该层的输入和输出维度。第一个形式保持前向传播的方差,第二个形式同时考虑前向和反向传播。
He 初始化针对 ReLU 激活函数设计。ReLU 把负半轴截断为零,导致输出的方差大约是输入方差的一半(因为一半的激活值被置零)。为了补偿这个损失,He 初始化把方差放大一倍:
W∼N(0,2nin) W \sim \mathcal{N}\left(0, \frac{2}{n_{\text{in}}}\right) W∼N(0,nin2)
这两个初始化方法的共同逻辑是:用激活函数的性质来反推权重的初始尺度。Xavier 假设激活函数在零点附近近似线性(tanh/sigmoid 的线性区),He 初始化显式地考虑了 ReLU 的截断效应。如果你换一个激活函数(比如 GELU 或 Swish),初始化的方差需要重新推导——初始化不是一个“通用超参数”,而是与激活函数和网络结构耦合的设计选择。
在大模型中,初始化的影响被 LayerNorm 和残差连接部分吸收,但仍然关键。Transformer 的残差连接要求子层的输出在初始化时接近零,否则残差路径上的方差会随层数累积。这就是为什么 GPT 类模型的输出投影层通常用更小的初始化尺度——让每个 Transformer 块在初始阶段近似为恒等映射,梯度可以无损地穿过几十层残差连接。
五、正则化:用偏差换方差
第 2 篇的偏差-方差分解给出了正则化的理论动机:增加模型复杂度会降低偏差但提高方差,正则化是用一点偏差换大方差。
L2 正则化(权重衰减)在损失中加入 (\lambda |\theta|^2),等价于对参数施加高斯先验。它的效果是让权重趋向于较小的值,从而限制模型的有效复杂度。第 3 篇的岭回归就是 L2 正则化在线性模型中的实例。
L1 正则化(Lasso)在损失中加入 (\lambda |\theta|_1),倾向于产生稀疏解——很多参数会精确变为零。这在特征选择场景中有用,但在深度网络中较少使用,因为深度网络的参数本身就是稠密表示,强制稀疏可能损害表达能力。
Dropout 在训练时以概率 (p) 随机将神经元的输出置零,推理时使用全部神经元但按 (1-p) 缩放输出。它的效果是强制模型不依赖特定的神经元组合,等价于训练了指数多个共享参数的子网络并做集成。Dropout 在 Transformer 的注意力权重和残差连接上都有应用,但在大模型中,Dropout 的使用比 CNN 时代更谨慎——因为大模型的训练数据量足够大时,过拟合不是主要矛盾,欠拟合和训练效率才是。
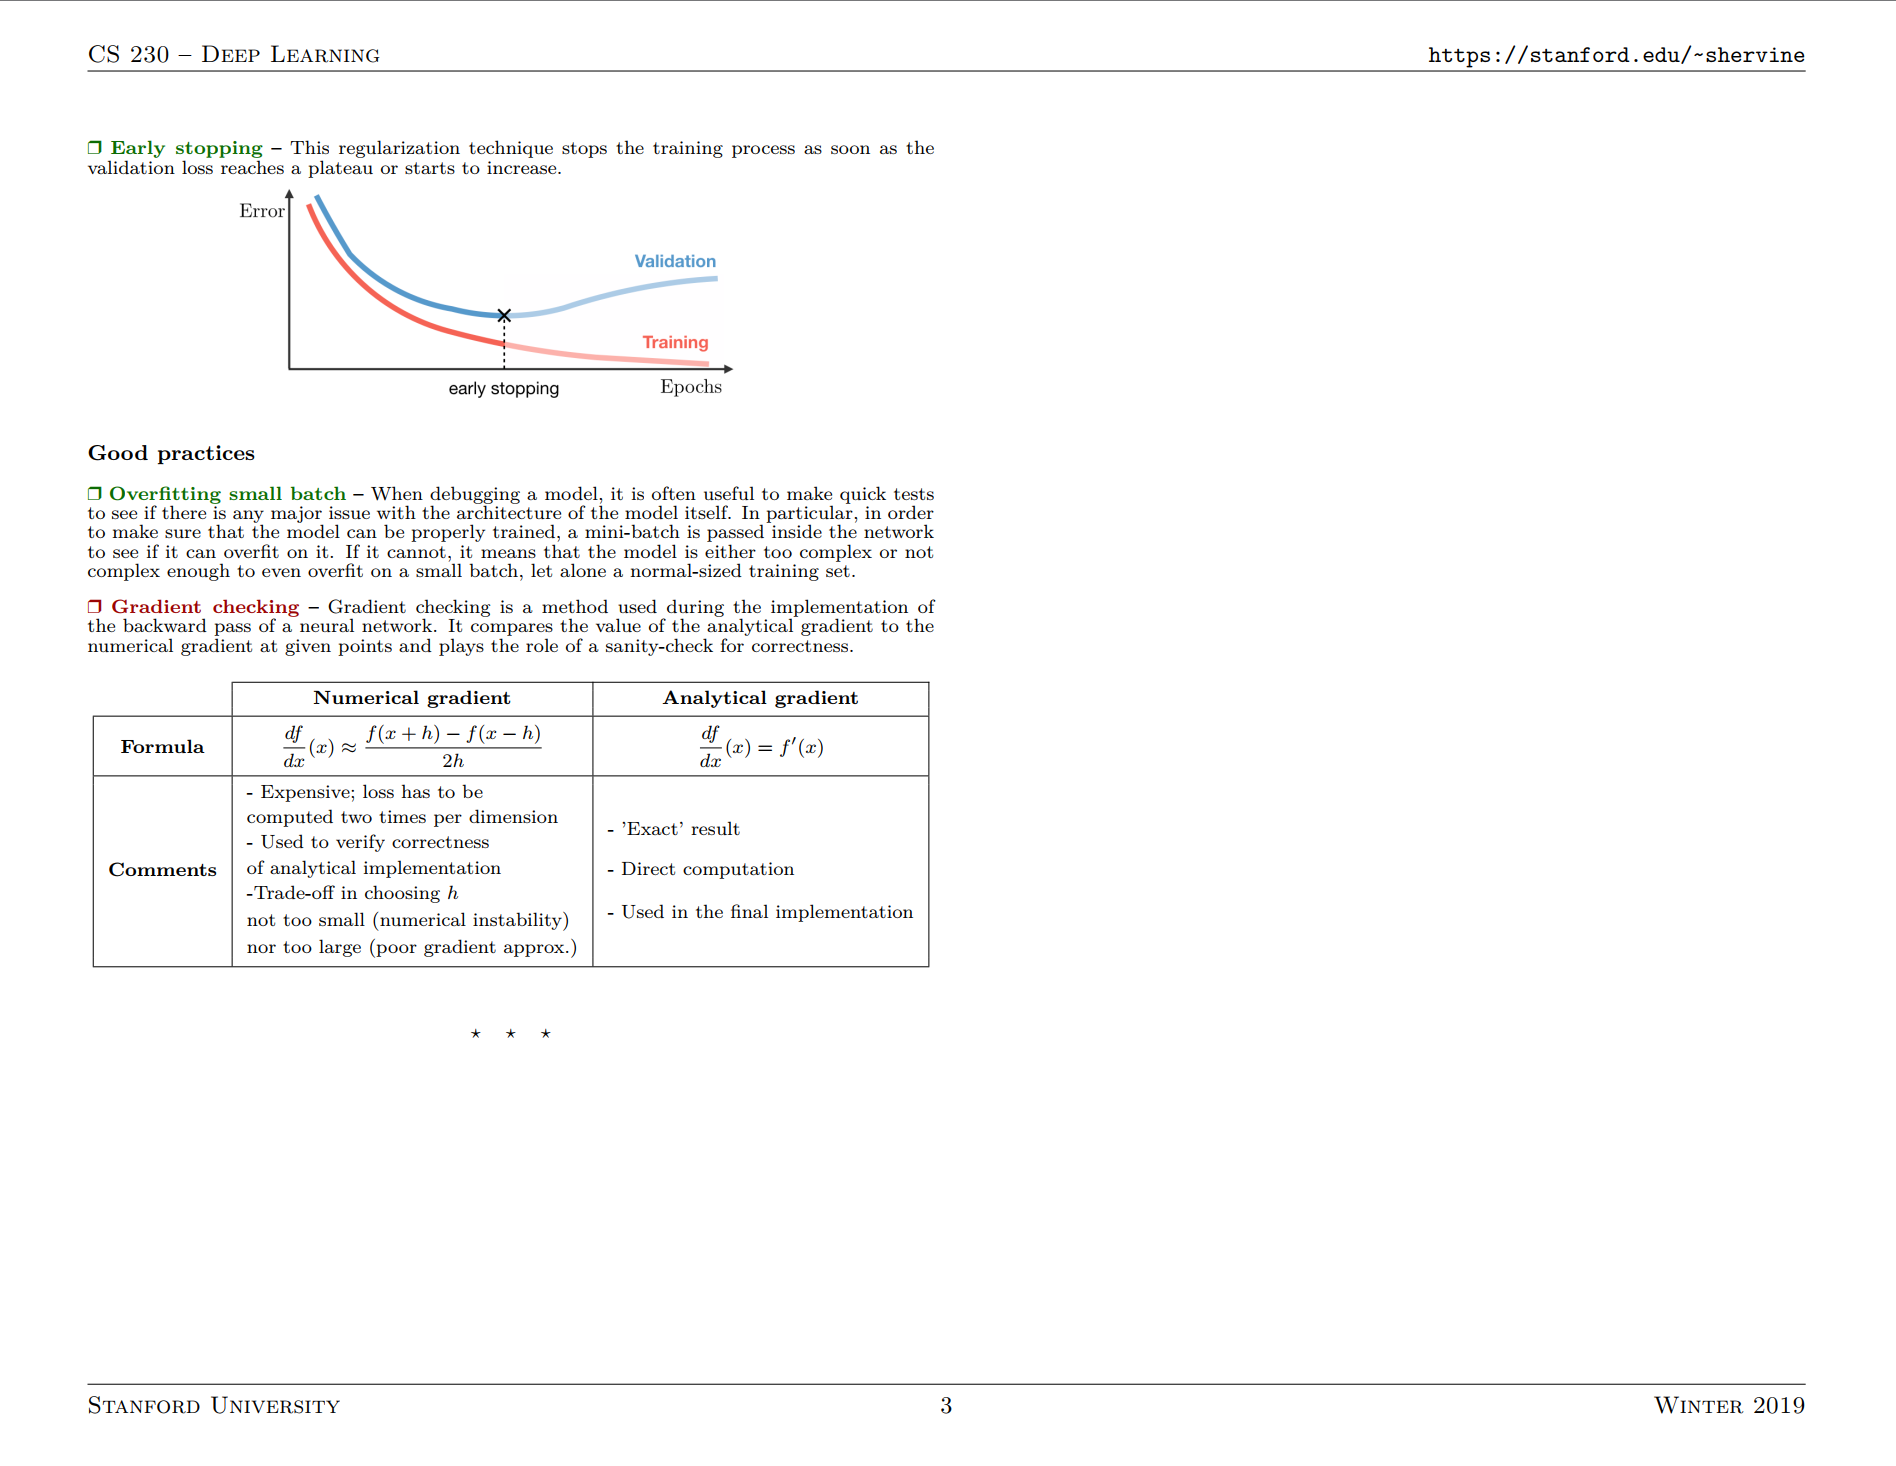
Early Stopping 在验证损失停止下降时终止训练,本质上是用训练步数作为正则化参数。它不需要修改损失函数,只需要监控验证集的表现。Anthropic 的 Constitutional AI 多阶段训练中,每个阶段都需要早停来判断“模型是否已经学会了当前阶段的目标,还是开始过拟合 SFT 数据”。
六、MATLAB 仿真:从 BatchNorm 到 Dropout
代码 1:BatchNorm 的前向与反向传播
% BatchNorm 前向传播与反向传播的数值验证
rng(42);
N = 8; D = 4;   % batch size, 特征维度
X = randn(N, D) * 3 + 5;   % 模拟分布偏移的输入
gamma = ones(1, D);
beta = zeros(1, D);
eps = 1e-5;

% 前向
mu = mean(X, 1);
var = var(X, 1);           % 总体方差
X_norm = (X - mu) ./ sqrt(var + eps);
Y = gamma .* X_norm + beta;

fprintf('输入均值: '); fprintf('%.3f ', mean(X,1)); fprintf('\n');
fprintf('输入方差: '); fprintf('%.3f ', var(X,1)); fprintf('\n');
fprintf('BN 后均值: '); fprintf('%.3f ', mean(Y,1)); fprintf('\n');
fprintf('BN 后方差: '); fprintf('%.3f ', var(Y,1)); fprintf('\n');

% 反向(简化:只验证 dX 的形式)
% dL/dY 假设为全 1(仅用于形状验证)
dY = ones(N, D);
dX_norm = dY .* gamma;
dvar = sum(dX_norm .* (X - mu) .* -0.5 .* (var + eps).^(-1.5), 1);
dmu = sum(dX_norm .* -1 ./ sqrt(var + eps), 1) + dvar .* mean(-2*(X - mu), 1);
dX = dX_norm ./ sqrt(var + eps) + dvar .* 2*(X - mu)/N + dmu/N;

fprintf('dX 形状: [%d, %d]\n', size(dX));
fprintf('说明:BN 的反向传播需要同时考虑标准化、方差和均值三条路径的梯度\n');
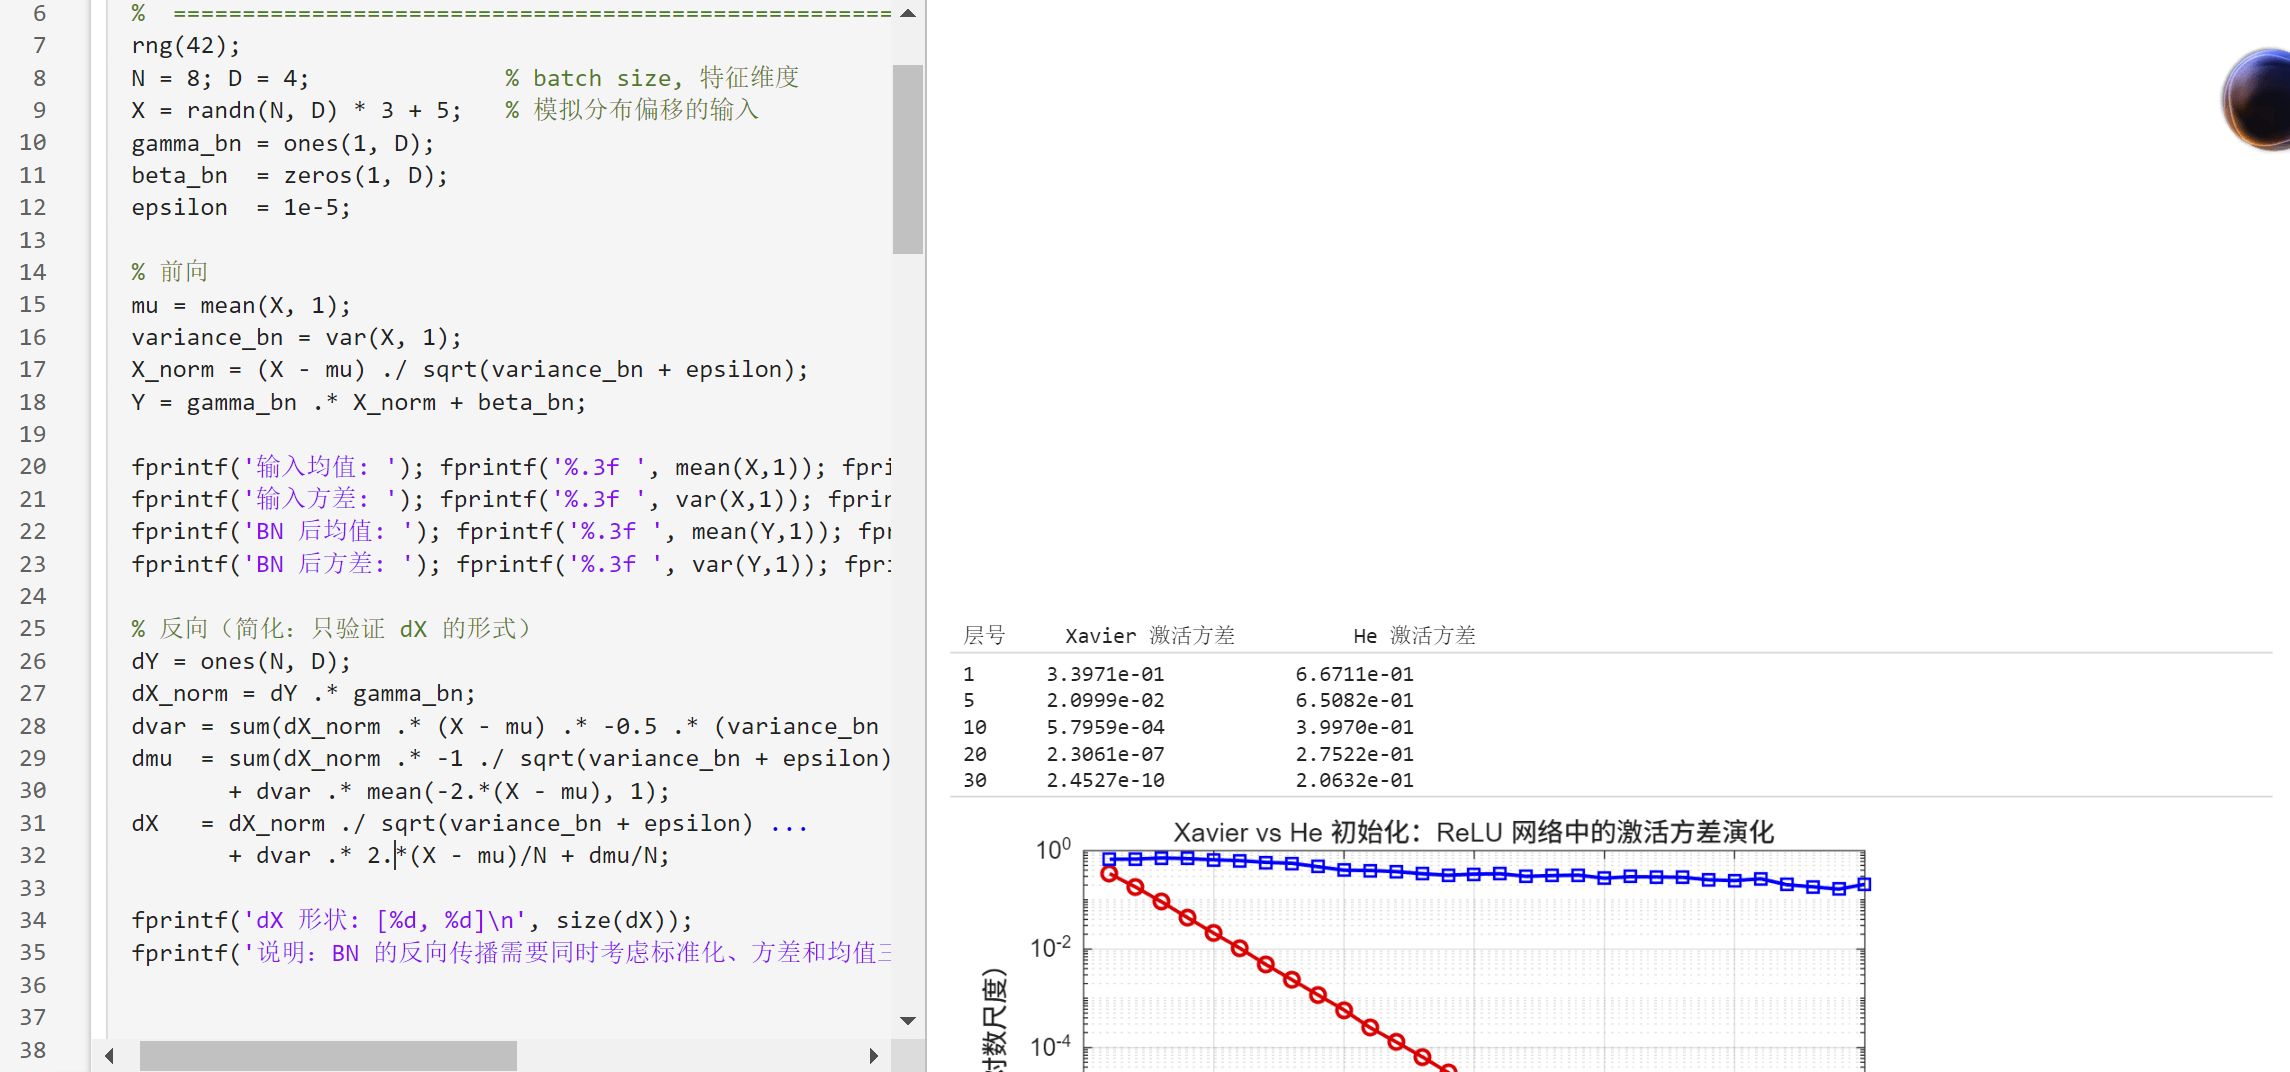
输出会显示:输入均值约为 5、方差约为 9,BN 后均值约为 0、方差约为 1。反向传播部分展示了 BN 的梯度不是简单的逐元素缩放——因为 (\mu) 和 (\sigma^2) 本身是 (X) 的函数,梯度需要穿过这三条路径。这个复杂性是 BN 在推理时使用移动平均统计量的原因:推理时不再计算 batch 统计量,而是用训练阶段累积的移动平均,从而避免依赖 batch 组成。
代码 2:Xavier vs He 初始化——激活值方差的逐层演化
% 初始化对比:Xavier vs He,观察激活值方差随层数的变化
rng(0);
depth = 30; width = 256; n = 128;
X = randn(n, width);

methods = {

      'xavier', 'he'};
variances = zeros(depth, 2);

for m = 1:2
    a = X;
    for l = 1:depth
        if strcmp(methods{

      m}, 'xavier')
            W = randn(width, width) * sqrt(1/width);
        else
            W = randn(width, width) * sqrt(2/width);
        end
        z = a * W;
        a = max(0, z);   % ReLU
        variances(l, m) = var(a(:));
    end
end

fprintf('%-6s %-20s %-20s\n', '层号', 'Xavier 激活方差', 'He 激活方差');
for l = [1, 5, 10, 20, 30]
    fprintf('%-6d %-20.4e %-20.4e\n', l, variances(l,1), variances(l,2));
end

figure;
semilogy(1:depth, variances(:,1), 'r-o', 'LineWidth', 1.5); hold on;
semilogy(1:depth, variances(:,2), 'b-s', 'LineWidth', 1.5);
xlabel('层号'); ylabel('激活值方差(对数尺度)');
title('Xavier vs He 初始化:ReLU 网络中的激活方差演化');
legend('Xavier (1/n_{in})', 'He (2/n_{in})', 'Location', 'southwest');
grid on;
运行结果会显示:Xavier 初始化下,激活方差随层数指数衰减(因为 ReLU 截断了一半的激活值);He 初始化下,方差保持相对稳定。这就是 He 初始化把方差放大一倍的动机——补偿 ReLU 的截断效应。如果你在 ReLU 网络上用 Xavier 初始化,30 层之后激活值会衰减到接近零,梯度也随之消失。
代码 3:Dropout 的训练/推理行为与正则化效果
% Dropout:训练时随机置零,推理时缩放
rng(7);
N = 6; D = 8; p = 0.5;   % dropout 概率
X = ones(N, D);           % 全 1 输入,便于观察

% 训练模式
mask = rand(N, D) > p;    % 保留概率 1-p
X_train = X .* mask / (1-p);   % inverted dropout:训练时缩放

% 推理模式
X_test = X;               % 推理时不丢弃,也不缩放(因为训练时已缩放)

fprintf('训练模式(保留概率 %.1f):\n', 1-p);
disp(X_train(1:3, :));
fprintf('推理模式:\n');
disp(X_test(1:3, :));

% 正则化效果:比较有/无 Dropout 的训练/测试误差
rng(1);
n_train = 50; n_test = 500;
x_tr = rand(n_train, 1) * 4 - 2;
y_tr = sin(2*x_tr) + 0.3*randn(n_train, 1);
x_te = linspace(-2, 2, n_test)';
y_te = sin(2*x_te);

% 简化:用随机特征 + 线性回归模拟一个容易过拟合的模型
Phi_tr = [x_tr, x_tr.^2, x_tr.^3, x_tr.^4, x_tr.^5, x_tr.^6];
Phi_te = [x_te, x_te.^2, x_te.^3, x_te.^4, x_te.^5, x_te.^6];

% 无 Dropout
w_no = (Phi_tr' * Phi_tr + 1e-8*eye(6)) \ (Phi_tr' * y_tr);
mse_train_no = mean((Phi_tr*w_no - y_tr).^2);
mse_test_no = mean((Phi_te*w_no - y_te).^2);

% 有 Dropout(训练时对特征做随机丢弃,等价于对输入加噪声)
n_sim = 20; preds = zeros(n_test, n_sim);
for s = 1:n_sim
    keep = rand(size(Phi_tr)) > 0.3;
    Phi_tr_drop = Phi_tr .* keep / 0.7;
    w = (Phi_tr_drop' * Phi_tr_drop + 1e-6*eye(6)) \ (Phi_tr_drop' * y_tr);
    preds(:, s) = Phi_te * w;
end
y_pred_drop = mean(preds, 2);
mse_train_drop = mean((mean(preds,2) - y_te).^2);  % 近似

fprintf('\n无 Dropout: 训练 MSE=%.4f, 测试 MSE=%.4f\n', mse_train_no, mse_test_no);
fprintf('有 Dropout: 测试 MSE=%.4f(近似)\n', mse_train_drop);
fprintf('说明:Dropout 通过训练时的随机性降低方差,代价是训练误差可能上升\n');
输出会显示:训练模式下,每个神经元的输出被随机置零,但保留下来的值被放大 (1/(1-p)) 倍,以保持期望不变;推理模式下,全部神经元参与,不需要额外缩放。这个“inverted dropout”的实现方式是现代框架的默认做法——它在训练时完成缩放,推理时保持恒等,简化了部署逻辑。
代码 4:L2 正则化强度对偏差-方差的影响
% L2 正则化:lambda 对训练/测试误差的影响
rng(3);
n_train = 30; n_test = 300;
x_tr = rand(n_train, 1) * 6 - 3;
y_tr = sin(x_tr) + 0.3*randn(n_train, 1);
x_te = linspace(-3, 3, n_test)';
y_te = sin(x_te);

% 高次多项式特征(容易过拟合)
deg = 12;
Phi_tr = zeros(n_train, deg+1);
Phi_te = zeros(n_test, deg+1);
for d = 0:deg
    Phi_tr(:, d+1) = x_tr.^d;
    Phi_te(:, d+1) = x_te.^d;
end

lambdas = [0, 1e-4, 1e-2, 0.1, 1, 10];
train_mse = zeros(size(lambdas));
test_mse = zeros(size(lambdas));

for i = 1:length(lambdas)
    lambda = lambdas(i);
    w = (Phi_tr' * Phi_tr + lambda * eye(deg+1)) \ (Phi_tr' * y_tr);
    train_mse(i) = mean((Phi_tr*w - y_tr).^2);
    test_mse(i) = mean((Phi_te*w - y_te).^2);
end

fprintf('%-10s %-15s %-15s\n', 'lambda', '训练 MSE', '测试 MSE');
for i = 1:length(lambdas)
    fprintf('%-10.4f %-15.4f %-15.4f\n', lambdas(i), train_mse(i), test_mse(i));
end

[~, best_idx] = min(test_mse);
fprintf('\n最优 lambda = %.4f, 对应测试 MSE = %.4f\n', lambdas(best_idx), test_mse(best_idx));
fprintf('说明:lambda 太小过拟合(训练误差低、测试误差高),lambda 太大欠拟合(两者都高)\n');
输出会显示一个 U 形的测试误差曲线:lambda=0 时训练误差很低但测试误差很高(过拟合);lambda 增大时测试误差先降后升。这个 U 形就是偏差-方差权衡在正则化强度上的直接体现——与第 3 篇 kNN 的 (k) 选择、第 2 篇多项式阶数选择是同一个逻辑的不同实例。
七、回到三条路线:工程方法是方法选择的“使能条件”
第 0 篇的三条路线,在训练阶段全部依赖这些工程方法才能落地。
DeepSeek 的 FP8 训练:混合精度训练的核心风险是数值下溢和上溢。FP8 的动态范围远小于 FP32,如果没有 LayerNorm 稳定激活分布、没有合理的初始化控制初始尺度、没有梯度裁剪防止爆炸,FP8 训练在早期就会发散。DeepSeek-V3 能在 2048 张 H800 上用 FP8 完成 671B 参数模型的训练,本身就是这些工程方法协同工作的证据。
OpenAI 的分层路由:路由器的初始化如果让所有 token 都分配给同一个专家,路由就会坍缩。负载均衡损失和合理的初始化是防止路由坍缩的工程手段。路由坍缩不是理论问题,而是工程问题——它在训练的前几百步就会发生,而且一旦发生就很难恢复。
Anthropic 的 Constitutional AI:多阶段训练(自我批评 → SFT → RLAIF)中,每个阶段都需要早停来判断“模型是否已经学会了当前阶段的目标”。如果没有验证集监控和早停,模型会在 SFT 数据上过拟合,导致后续 RLAIF 阶段的初始策略偏离目标分布。宪法从 2700 词扩展到 23000 词,这个改动是否真的改善了行为,需要通过验证集和早停来客观判断,而不是靠训练损失。
八、本篇在系列中的位置
第 4 篇给了反向传播的数学形式,本篇给了让反向传播在真实训练中稳定运行的工程条件:数据增强注入不变性先验、BatchNorm/LayerNorm 稳定激活分布、Xavier/He 初始化控制初始梯度尺度、L1/L2/Dropout/Early Stopping 调节偏差-方差平衡。
下一篇进入第 6 篇:卷积神经网络——局部特征、层次表示与视觉任务。前五篇的方法(概率、评估、监督学习、自监督学习、深度学习基础、工程方法)都是与数据形态无关的通用方法;从第 6 篇开始,系列进入结构归纳偏置:CNN 的局部性和权重共享、RNN 的序列记忆、无监督学习的表示提取,分别对应不同数据形态的结构假设。CNN 的卷积核是“局部感受野 + 权重共享”的工程化实现,这个思想在第 7 篇的注意力机制中会被重新审视——注意力可以看作一种“全局感受野 + 数据自适应权重”的推广。
下一篇:第 6 篇《卷积神经网络:局部特征、层次表示与视觉任务》
参考阅读: