数据类型
int 4字节 最大值约为 21 亿(2.1 × 10^9)
算法时间复杂度
| 符号 | 含义 | 与精确下界的关系 |
|---|---|---|
| Θ(f(n)) | 紧确界 | T(n) ∈ Θ(f(n)) ⇒ 上下界都是f(n) |
| O(f(n)) | 上界 | 提供性能保证 |
| Ω(f(n)) | 下界 | 提供性能极限 |
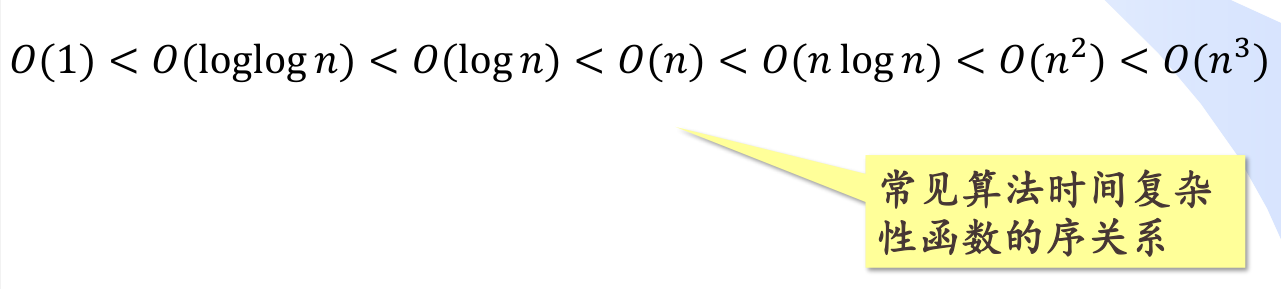 |
ADT 线性表
元素用一条线串起来 顺序存储和链式存储
Array
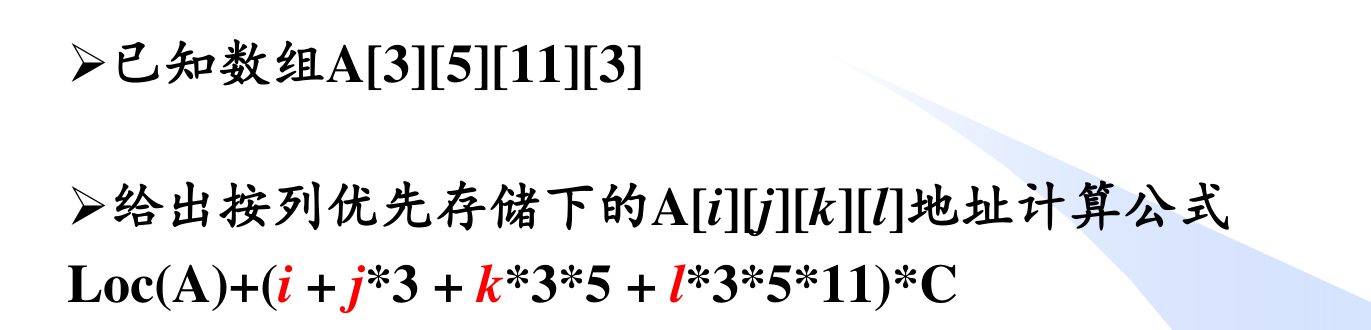
行、列优先存储是将多维数组映射到一维线性内存空间的两种主要方式
| 特性 | 行优先 (Row-Major) | 列优先 (Column-Major) |
|---|---|---|
| 常见语言 | C, C++, Java, Python | Fortran, MATLAB, R |
| 连续元素 | 同一行的元素内存连续 | 同一列的元素内存连续 |
| 索引变化 | 最右侧索引变化最快 | 最左侧索引变化最快 |
一维定位loc公式
注意 这里数组下标是0-based 1-based 将所有下标减 1 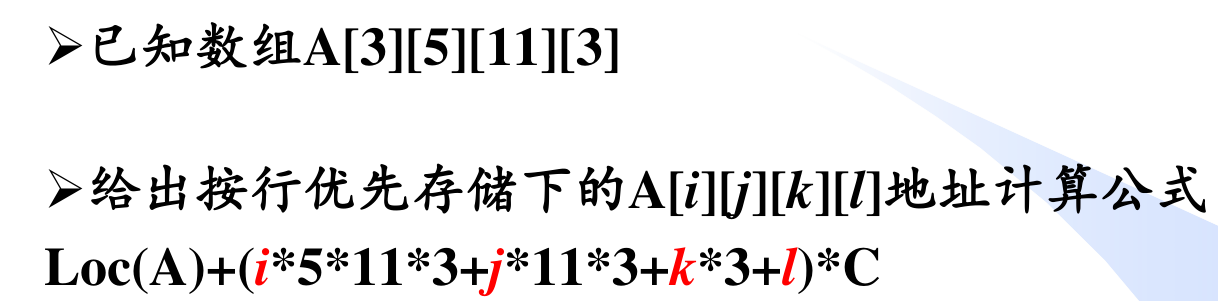
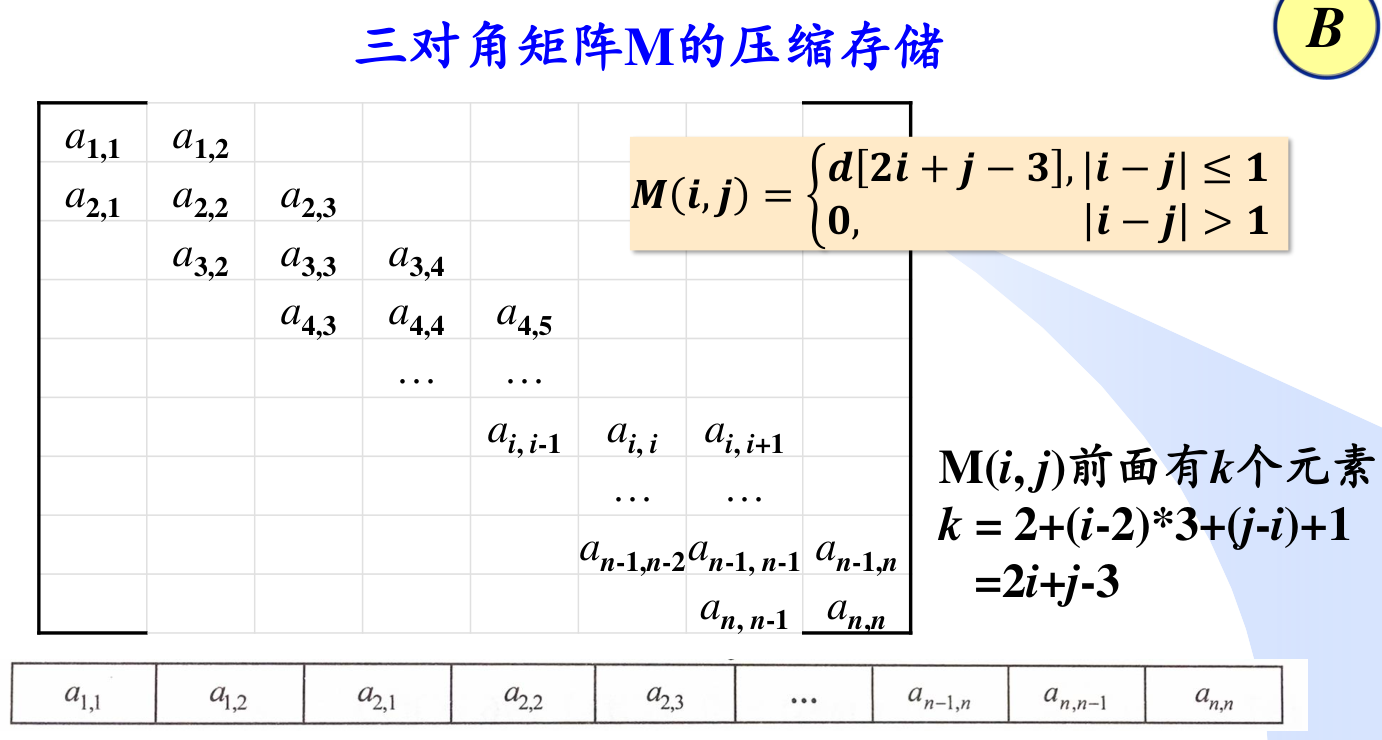
压缩存储
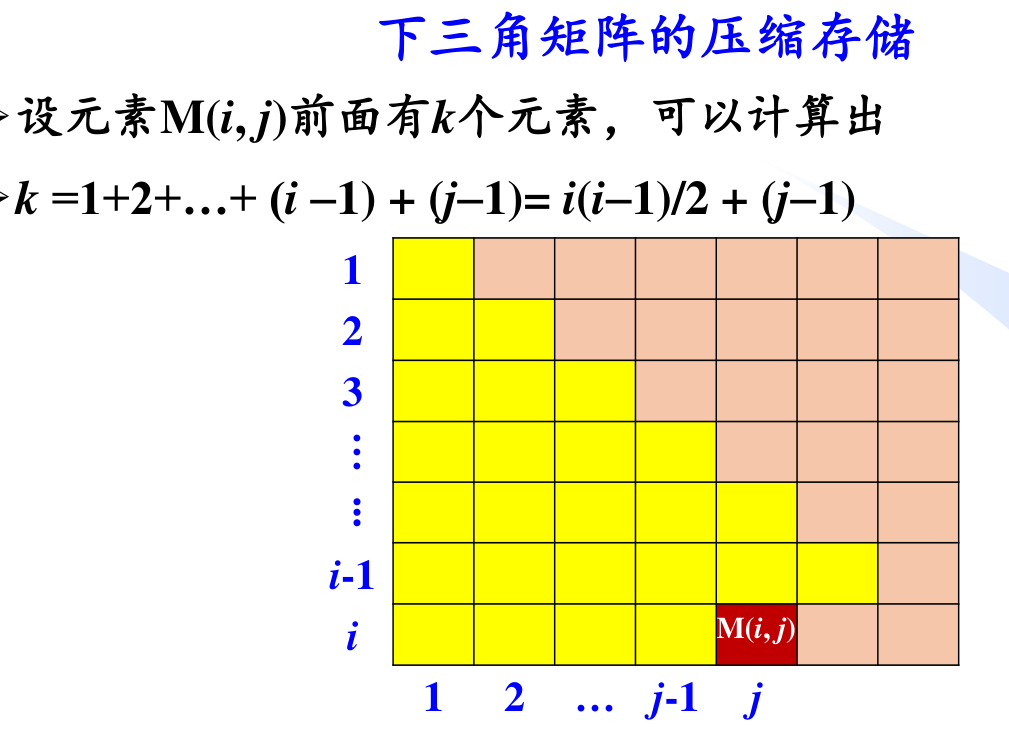
| 存储方式 | 适用条件 | 下标计算公式 |
|---|---|---|
| 上三角 + 行优先 | i l e j i \\le j ilej | t e x t i n d e x = f r a c ( i − 1 ) ( 2 n − i + 2 ) 2 + ( j − i ) \\text{index} = \\frac{(i-1)(2n - i + 2)}{2} + (j - i) textindex=frac(i−1)(2n−i+2)2+(j−i) |
| 下三角 + 列优先 | i g e j i \\ge j igej | t e x t i n d e x = f r a c ( j − 1 ) ( 2 n − j + 2 ) 2 + ( i − j ) \\text{index} = \\frac{(j-1)(2n - j + 2)}{2} + (i - j) textindex=frac(j−1)(2n−j+2)2+(i−j) |
同样的对称逻辑也适用于另外两种组合:
| 存储方式 | 适用条件 | 下标计算公式 |
|---|---|---|
| 下三角 + 行优先 | i g e j i \\ge j igej | t e x t i n d e x = f r a c i ( i − 1 ) 2 + j − 1 \\text{index} = \\frac{i(i-1)}{2} + j - 1 textindex=fraci(i−1)2+j−1 |
| 上三角 + 列优先 | i l e j i \\le j ilej | t e x t i n d e x = f r a c j ( j − 1 ) 2 + i − 1 \\text{index} = \\frac{j(j-1)}{2} + i - 1 textindex=fracj(j−1)2+i−1 |
 |
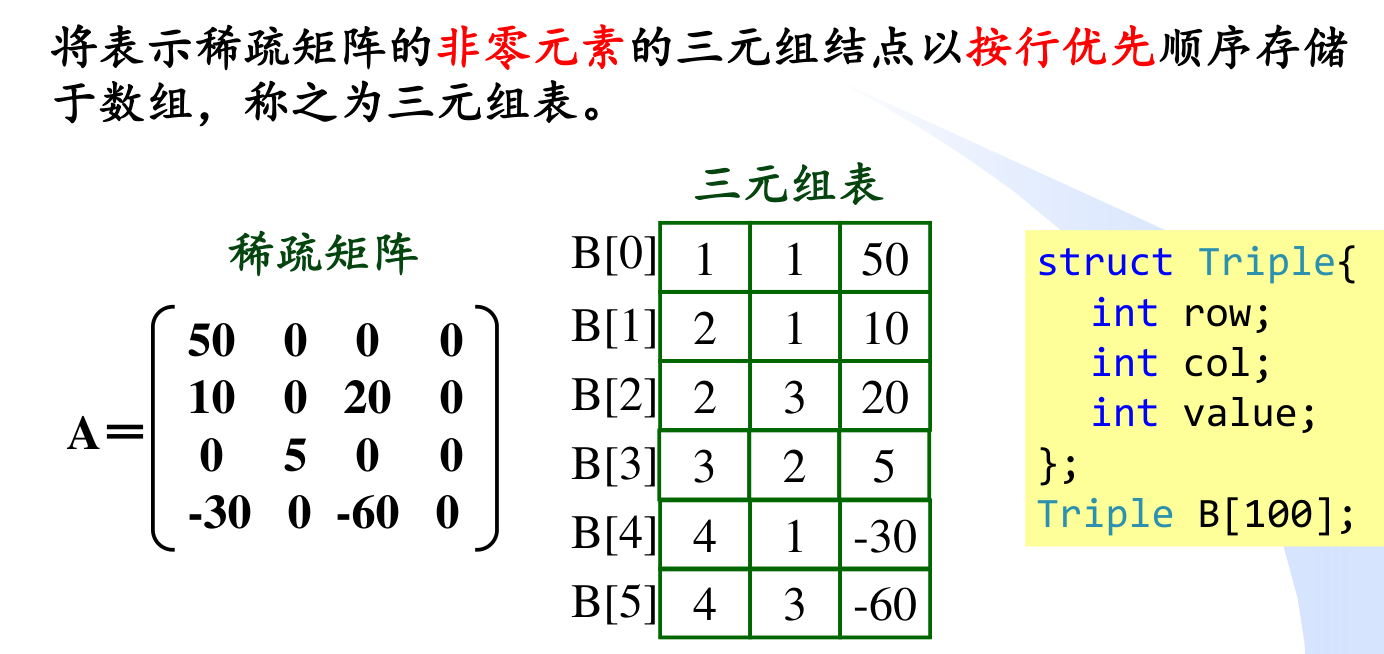
十字链表
动态数组
动态扩容 ×2
环形数组
删除元素不再需要搬运元素 最大的优势在于以均摊 O(1) 的复杂度在数组的头部和尾部同时进行添加/删除操作。
那为什么 动态数组底层不用环形的呢? A:取模操作影响了极致的随机访问性能;实现的复杂性与迭代器;破坏了“单一连续内存块”(缓存命中 (Cache Hit))
这使得它成为实现双端队列 (Deque) 的完美数据结构
栈和队列
栈是 后入先出LIFO
中缀表达式转后缀表达式算法:
设置一个栈,存放运算符 从左到右依次读入中缀表达式的每一个元素: ➢操作数规则:直接放入后缀表达式 ➢运算符规则: (1) 栈空或栈顶是左括号:压栈 (2) 当前运算符优先级> 栈顶运算符:压栈 (3) 当前运算符优先级小于栈顶运算符:弹栈直至当前运算符 优先级>栈顶或栈空或栈顶为左括号(期间弹出的运算符顺序依次放入后缀表达式),再把当前运算符压栈 ➢括号规则: (1) 遇到左括号:压栈 (2) 遇到右括号:弹栈直至左括号 ➢结束符规则:弹栈至栈空
栈混洗和卡特兰数
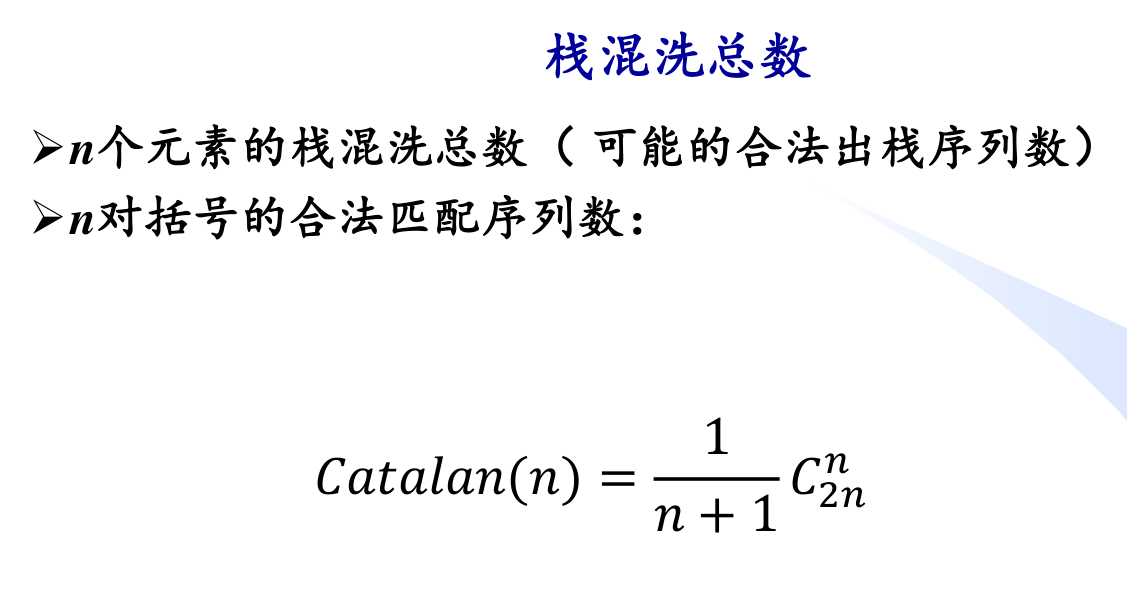
t e x t C a t a l a n 公式 ( n ) = f r a c 1 n + 1 b i n o m 2 n n = f r a c ( 2 n ) ! ( n + 1 ) ! n ! \\text{Catalan公式}(n) = \\frac{1}{n+1} \\binom{2n}{n} = \\frac{(2n)!}{(n+1)!n!} textCatalan公式(n)=frac1n+1binom2nn=frac(2n)!(n+1)!n!
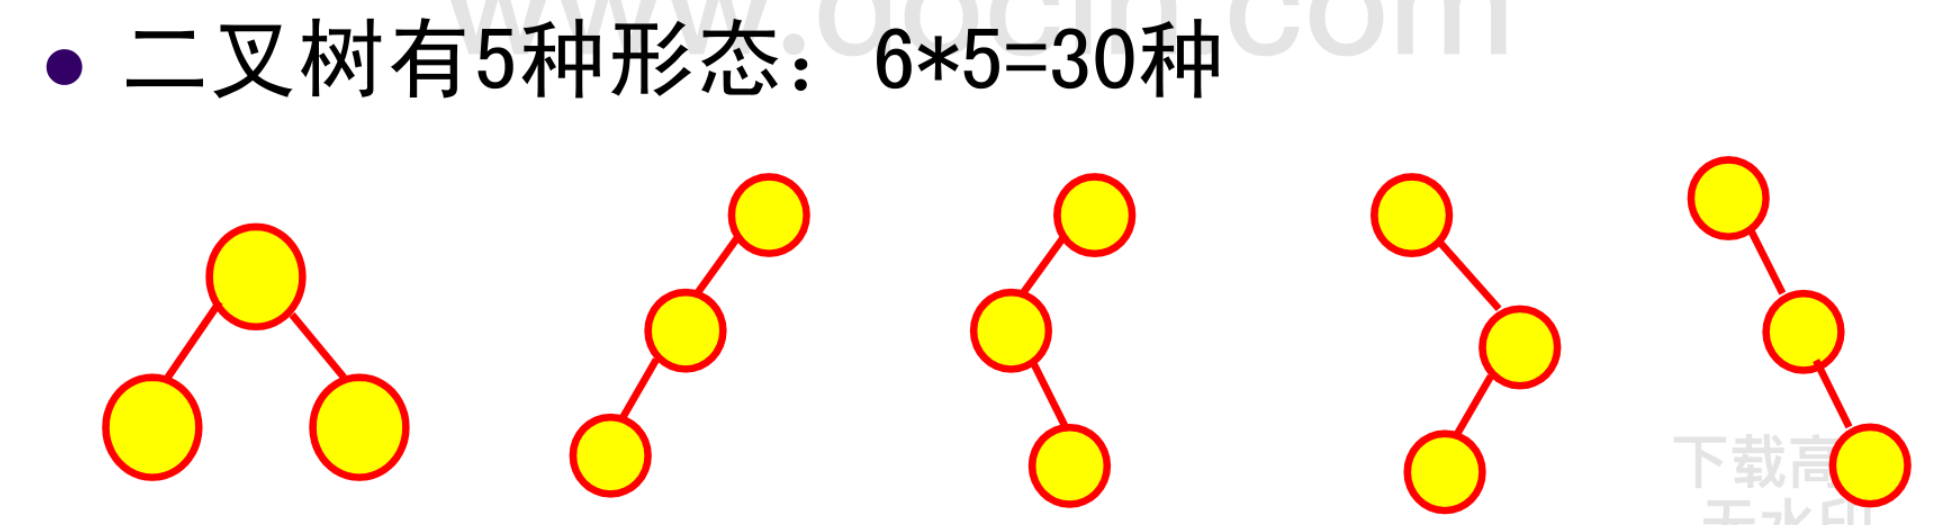
含有 𝑛
队列
先入先出 FIFO
循环队列的数组实现
front指向队首元素,rear指向队尾元素的下一个位置
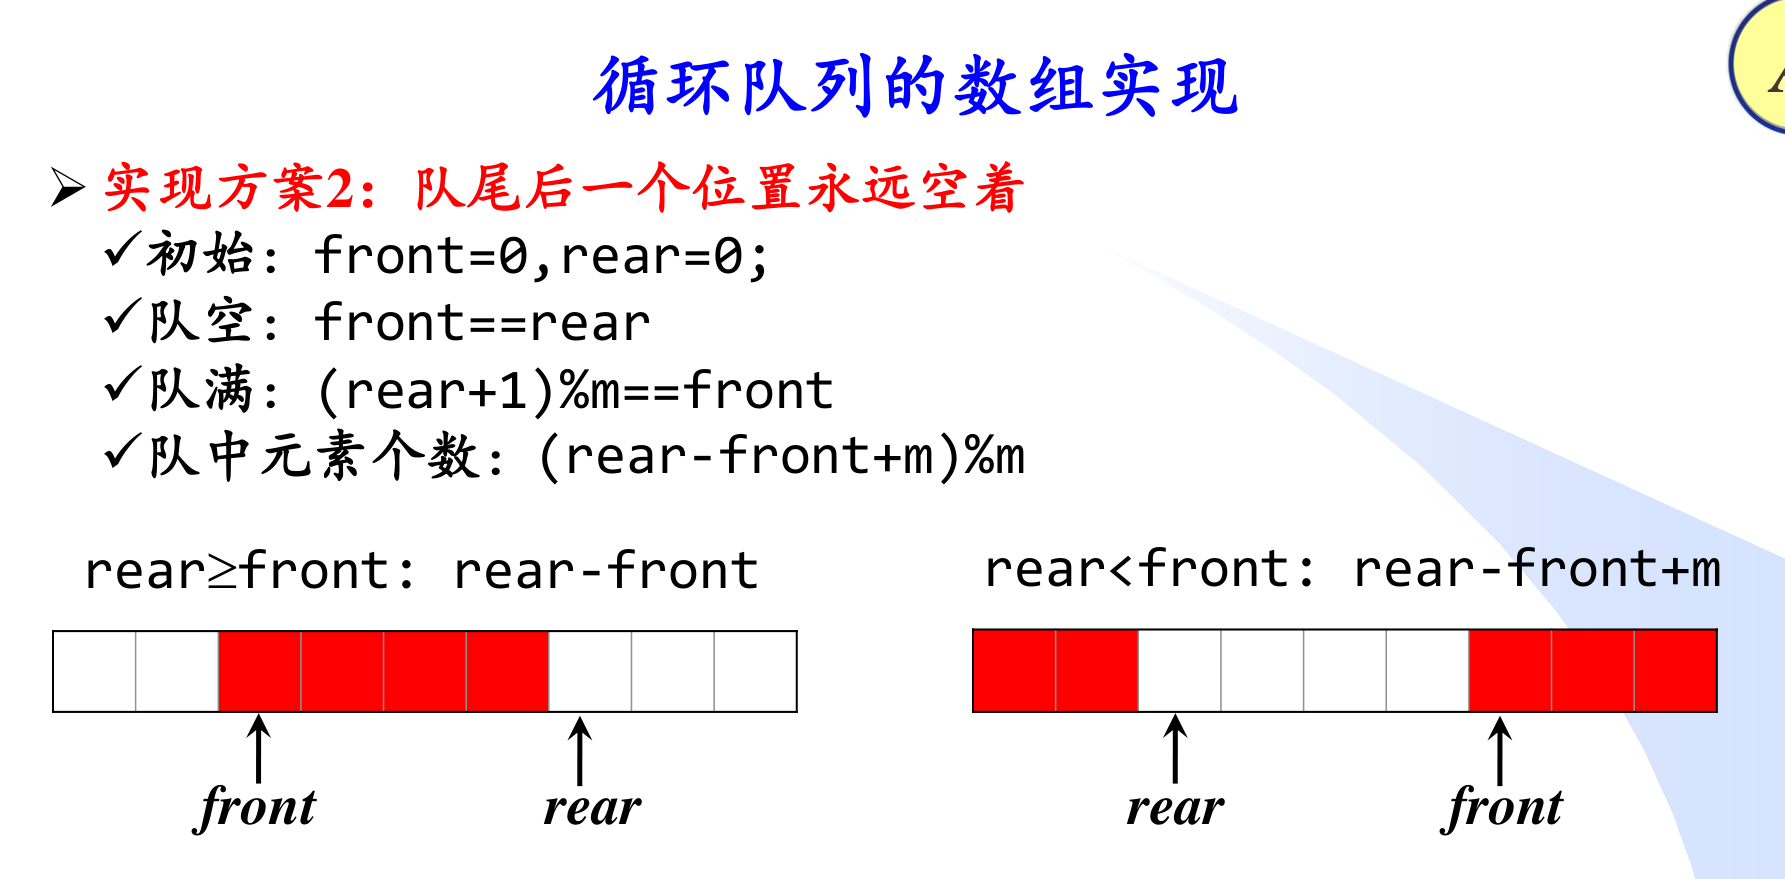
单调栈、单调队列 deque是双向队列、queue单向队列
顺序堆栈和链式堆栈 最根本的区别就是底层存储结构的不同(数组 vs. 链表) 数组实现栈 top初始化为-1
优先队列最常见的实现是[[#堆]]
栈与队列的相互实现
- 两个栈实现队列:
StackIn负责入队,StackOut负责出队。- 入队:直接 Push 到
StackIn。 - 出队:若
StackOut为空,将StackIn所有元素 Pop 并 Push 到StackOut,然后StackOutPop。 - 复杂度:均摊 O ( 1 ) O(1) O(1)。
- 两个队列实现栈:
- 保持一个队列为空,另一个存储数据。
- 入栈:入到非空队列。
- 出栈:将非空队列的前 n − 1 n-1 n−1 个元素依次出队并入队到另一个空队列,最后剩下的第 n n n 个元素出队返回。
- 复杂度:入栈 O ( 1 ) O(1) O(1),出栈 O ( N ) O(N) O(N)。
链表
SLList DLList 循环链表 双向循环链表
静态链表
pros:能够像顺序表一样快速地访问数据元素,又可以像动态链表一样方便地插入、删除和移动数据元素 cons 访问如存储元素个数固定
数据元素配备一个整形变量,此变量用于指明各个元素的直接后继元素所在数组中的位置下标
跳舞链
跳表
利用空间换时间的思想,用额外的空间记录额外的信息,增删查改的时间复杂度都能优化到 O(logN)
KMP
Next 数组的性质
next[j] 存储的是模式串 P P P 中前 j j j 个字符组成的子串(即 KaTeX parse error: Undefined control sequence: \[ at position 2: P\̲[̲0 \\dots j-1\])的最长相等前后缀长度。(且不包含子串本身) next函数(失败函数、前缀函数)
✓next函数仅与模式串P有关,而与目标串S无关。
✓可以预先把P中所有位置的next(j) 算出来,存入数组next[j]。
✓匹配过程中若在Pj失配,则直接令j == next[j]作为P下次匹配的位置(相对移动)


字符串长度为n
➢最长相等的前后缀长度:next[n].
➢第二长相等的前后缀长度:next[next[n]].
➢最长重复前缀:next数组中的最大值maxi(next[i]).

next数组的计算:
void buildNext(char *P, int next[], int m){


	int k=next[0]=-1;
	for(int j=0; j<m-1; j++){

       //求next[j+1], j+1<m
		while(k>=0 && P[k]!=P[j])
			k=next[k]; //求p0…pk-1的最长相等前后缀
		next[j+1]=++k;
	}
}
KMP的应用
KMP 的 next 数组不仅是用来“跳过不匹配字符”的,它本质上记录了字符串的自相似度。
- 想加速匹配? 用
next[j]回溯。 - 想找循环节? 用 KaTeX parse error: Undefined control sequence: \[ at position 11: Len - next\̲[̲Len-1\]。
- 想找前后缀嵌套? 用
next[next[x]]递归。
树
树是一个连通的、无环的无向图
树的三种表示法:双亲表示法、孩子表示法、孩子兄弟表示法(指针指向谁)
一个结点的度指该结点的子结点的数目
二叉树
底层存储 数组、链表 任一二叉树满足: n _ 0 = n _ 2 + 1 ( 下标为度 ) n\_0=n\_2+1 (下标为度) n_0=n_2+1(下标为度)
链式存储的话,空指针个数=节点数+1
完全二叉树
定义:除二叉树的最高层h外其它各层 (1~h-1) 的节点数都达到最大个数;第h层有叶子结点,并且叶子结点都是从左到右依次排布;
推论:
- 度为1的节点只能有1个
- 高度为k的完全二叉树最少有2^k个结点
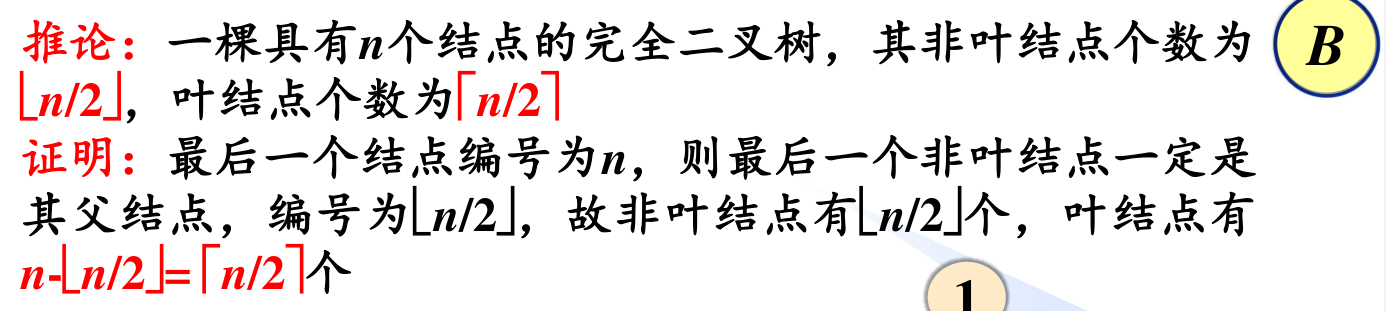
最理想存储结构就是数组
假设根节点存储在索引 0 的位置。
- 左子节点索引: 2⋅i+1
- 右子节点索引: 2⋅i+2
- 父节点索引: (i−1)/2 (对于任意子节点
i) 数组表示的完全二叉树本身就是一种层序的表示法 优缺点: 二叉树的数组表示主要有以下优点。 - 数组存储在连续的内存空间中,对缓存友好,访问与遍历速度较快。
- 不需要存储指针,比较节省空间。
- 允许随机访问节点。 然而,数组表示也存在一些局限性。
- 数组存储需要连续内存空间,因此不适合存储数据量过大的树。
- 增删节点需要通过数组插入与删除操作实现,效率较低。
- 当二叉树中存在大量
None时,数组中包含的节点数据比重较低,空间利用率较低。
满二叉树
总节点数就是 2^(h+1) - 1 h从0开始 是深度
二叉树的遍历
二叉树的遍历函数时间复杂度是 O(3N),其中 N 是节点的总数。
递归遍历(DFS)
节点遍历的顺序是“固定”的,每个节点都被遍历三次,前中后序只是输出时机不同 中根遍历:当一个节点的左子树全部处理(递归返回)完毕后,立即输出该节点,然后再去处理它的右子树。 后根遍历:当一个节点的左、右子树全部处理(递归返回)完毕后,再输出该节点。 如果非递归实现 可以用栈模拟递归(即DFS也可以基于迭代实现) 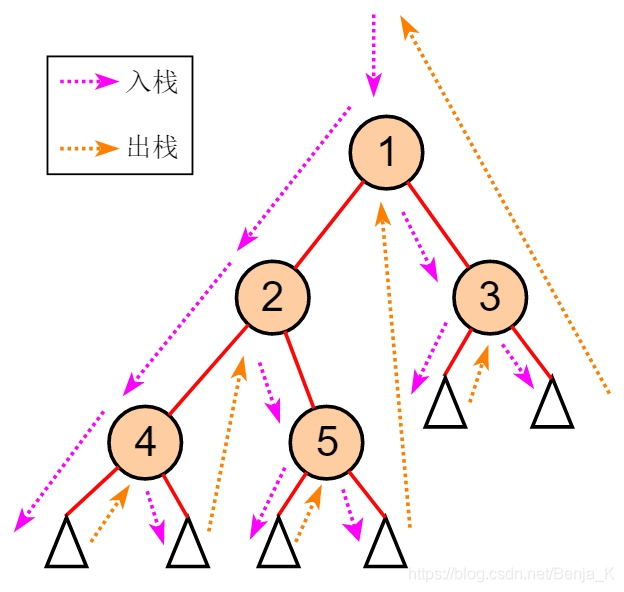
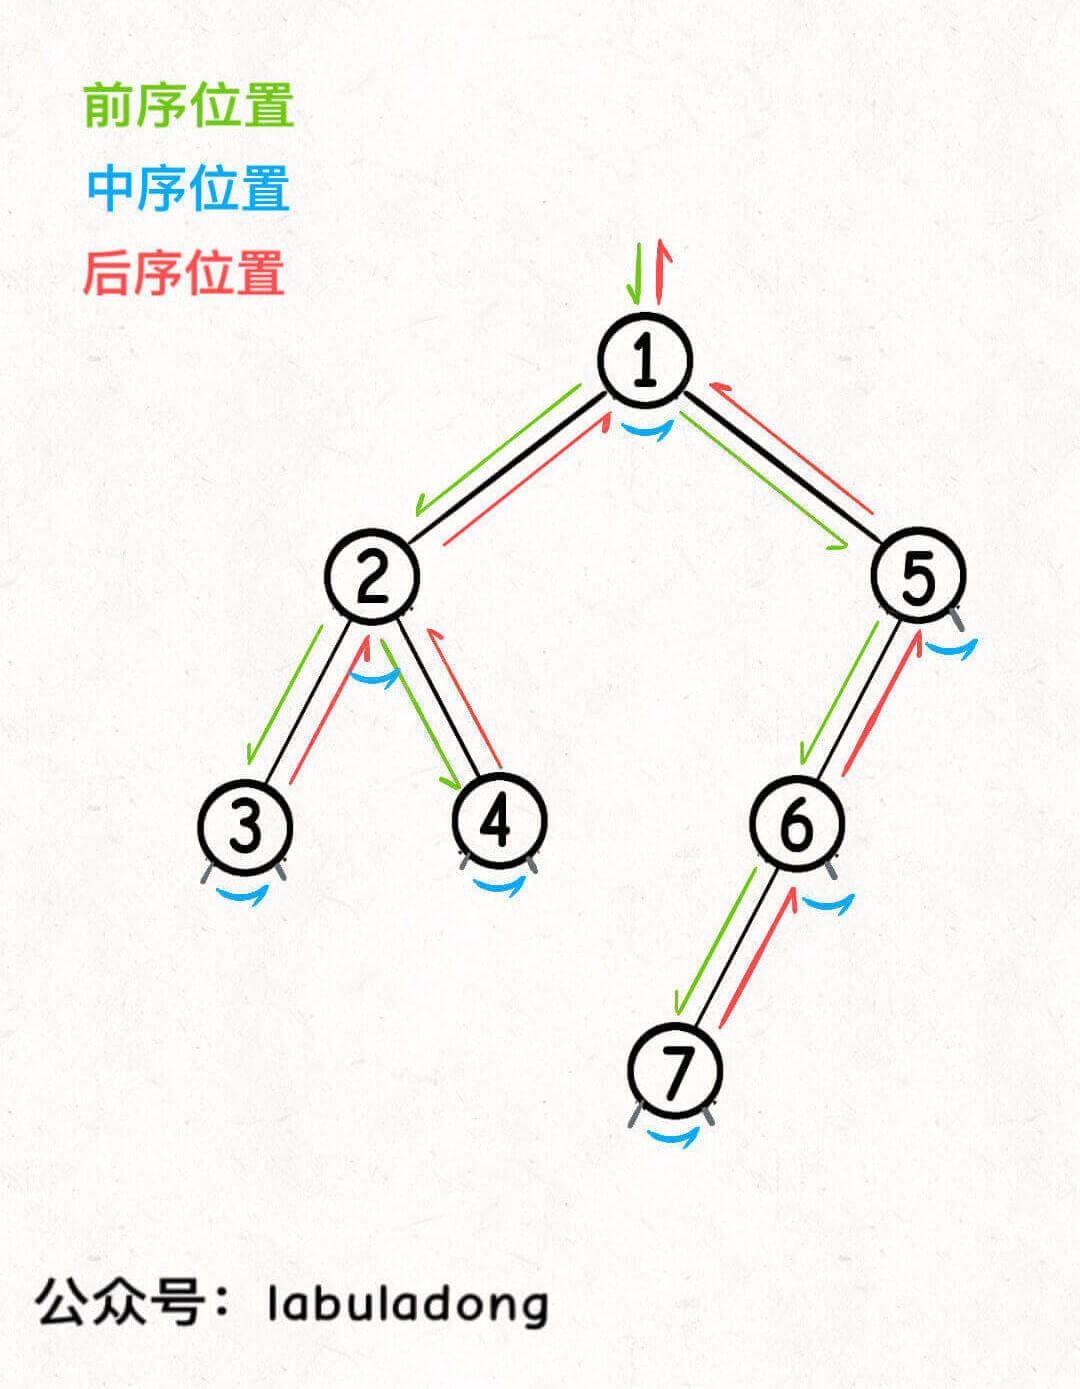
先根遍历:结点进栈顺序就是先根访问的顺序,即进栈序列=先根序列 中根遍历:结点出栈顺序就是中根访问的顺序,即出栈序列=中根序列
显然 叶节点的相对顺序是不变的
层序遍历(BFS)
层序遍历需要借助队列来实现,而且根据不同的需求,可以有三种不同的写法
为什么 BFS 常用来寻找最短路径 由于 BFS 逐层遍历的逻辑,第一次遇到目标节点时,所经过的路径就是最短路径,算法可能并不需要遍历完所有节点就能提前结束。
二叉树的构建/构造
中根序列和任意一种遍历序列都可以唯一地确定一棵二叉树
| 组合 | 是否能唯一确定二叉树 | 结论理由(一句话) |
|---|---|---|
| 层次 + 前序 | ✅ 可以 | 根由层次首元素确定,前序确定子树展开顺序 |
| 层次 + 中序 | ✅ 可以 | 中序确定左右结构,层次确定父子优先级 |
| 层次 + 后序 | ✅ 可以 | 根由层次确定,后序限制子树收束方式 |
| 在二叉树递归中,修改树结构的核心技巧就是“接收返回值并重新赋值”。返回 null 就是把对应的子节点指针置空,从而移除该节点 |
BST二叉搜索树
左子树所有节点值 < 根节点值 < 右子树所有节点值 故BST的中序遍历是有序的
二叉查找树—删除算法: K只有1个孩子,则子承父业(让其子结点替换K)。 K有2个孩子,则在其右子树找关键词最小的结点s(即右子树中根序列的第一个结点,亦即K的中根后继)替换K ,然后删除原结点s( s只有一个右孩子或无孩子)。
线索二叉树
问题引入:怎么找x序遍历中 任意节点的前驱和后继节点
充分利用空指针,用tag变量标记线索 用于区分指向孩子和指向前驱后继:
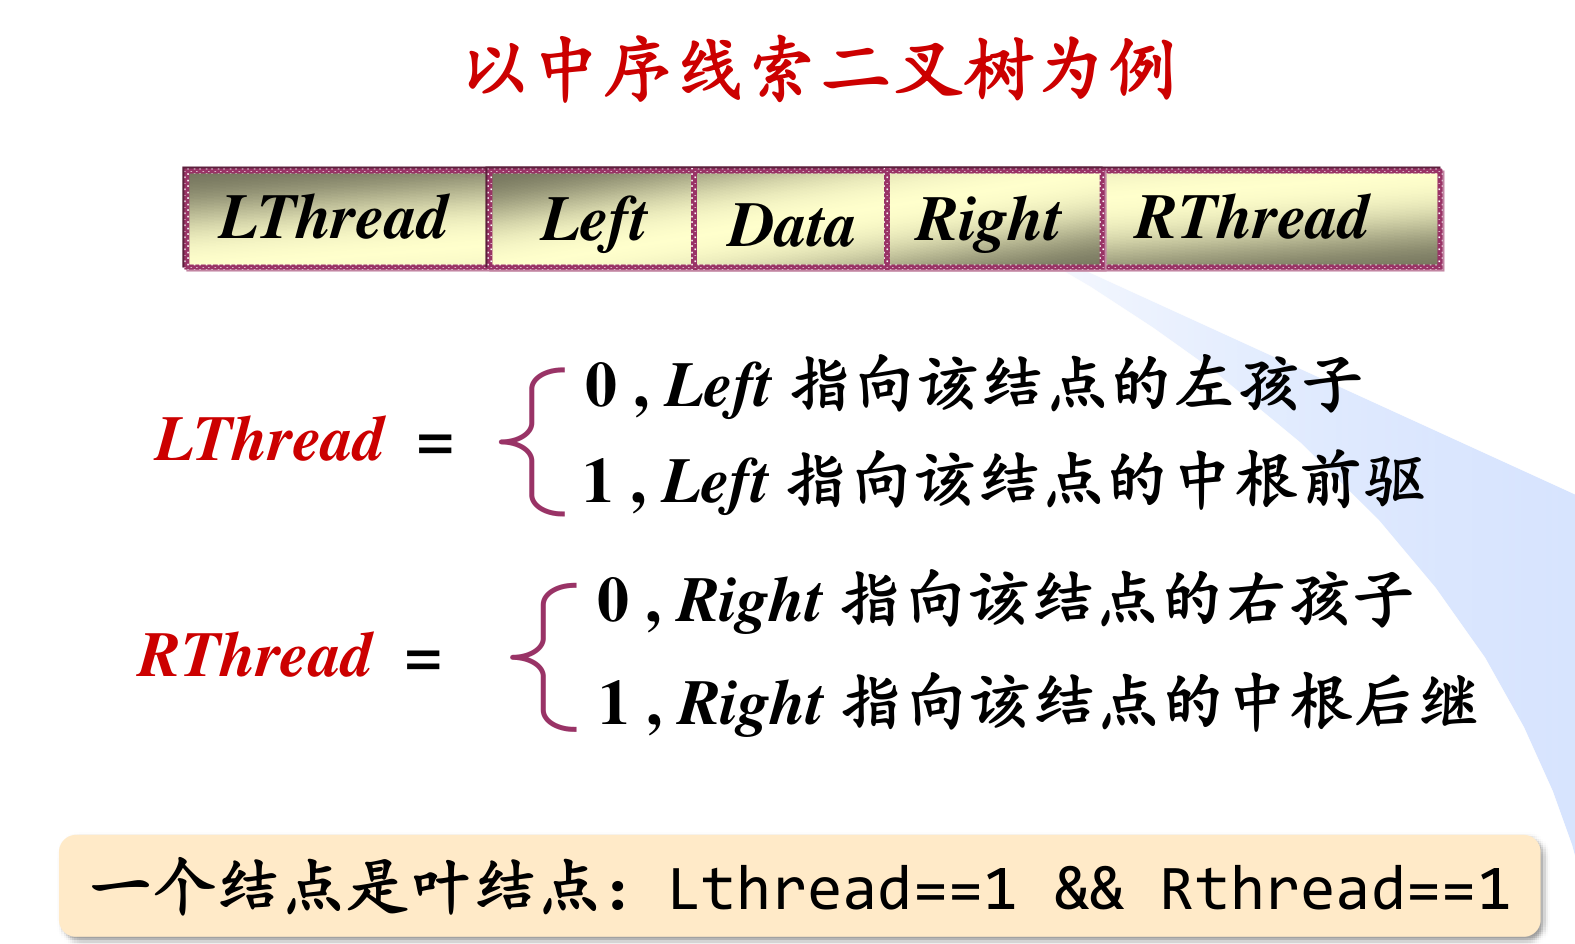
中序线索二叉树的中根遍历的优势是省去了栈空间 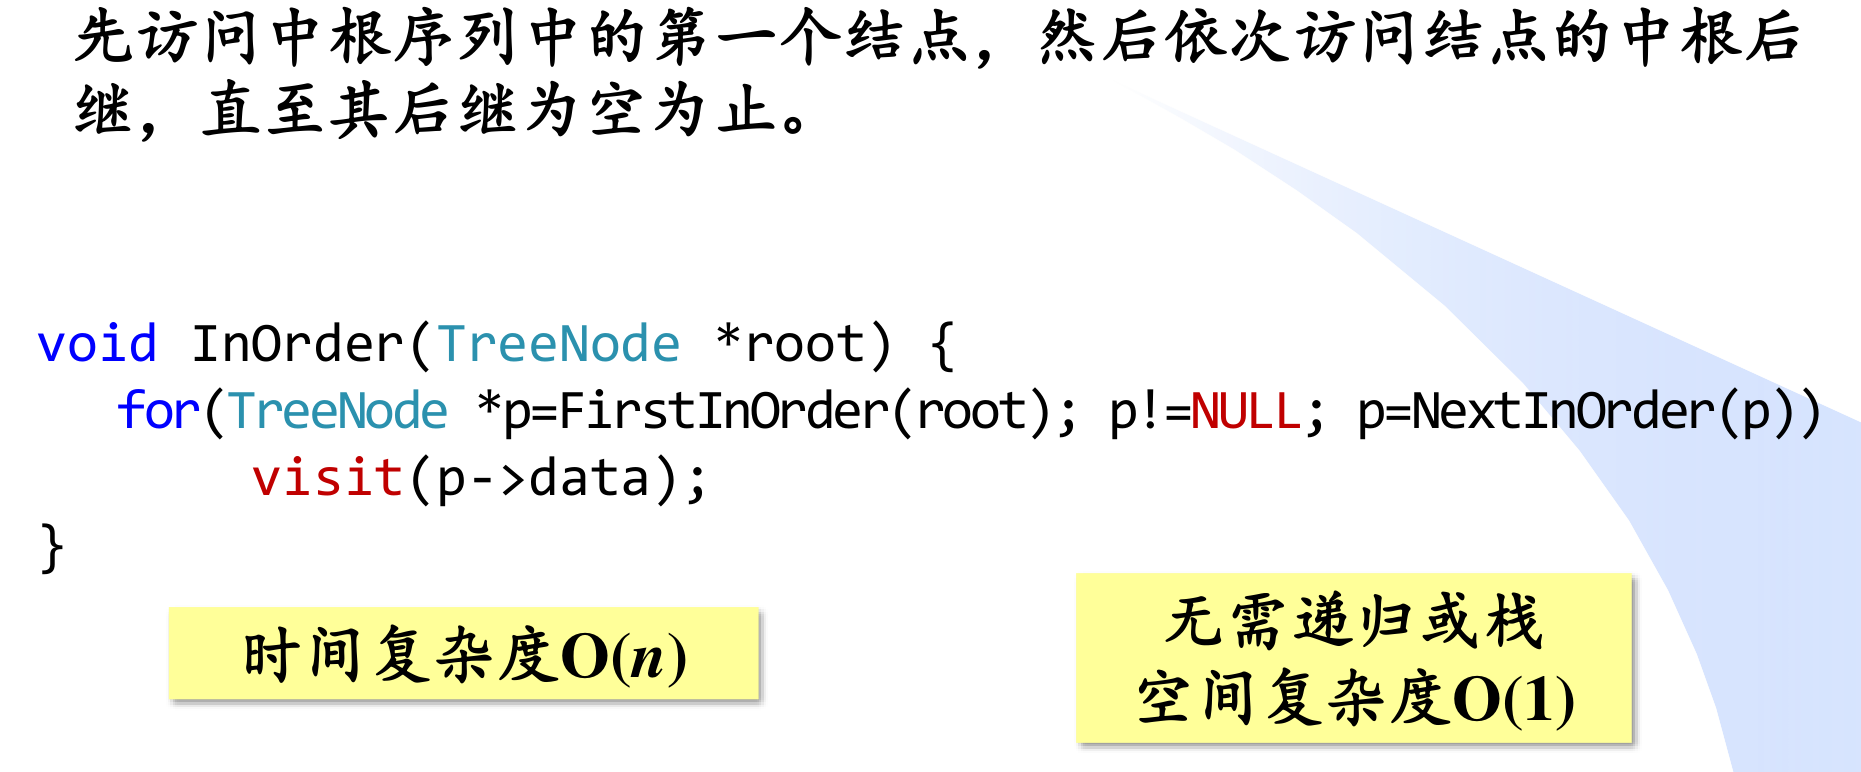
二叉树的中序线索化:
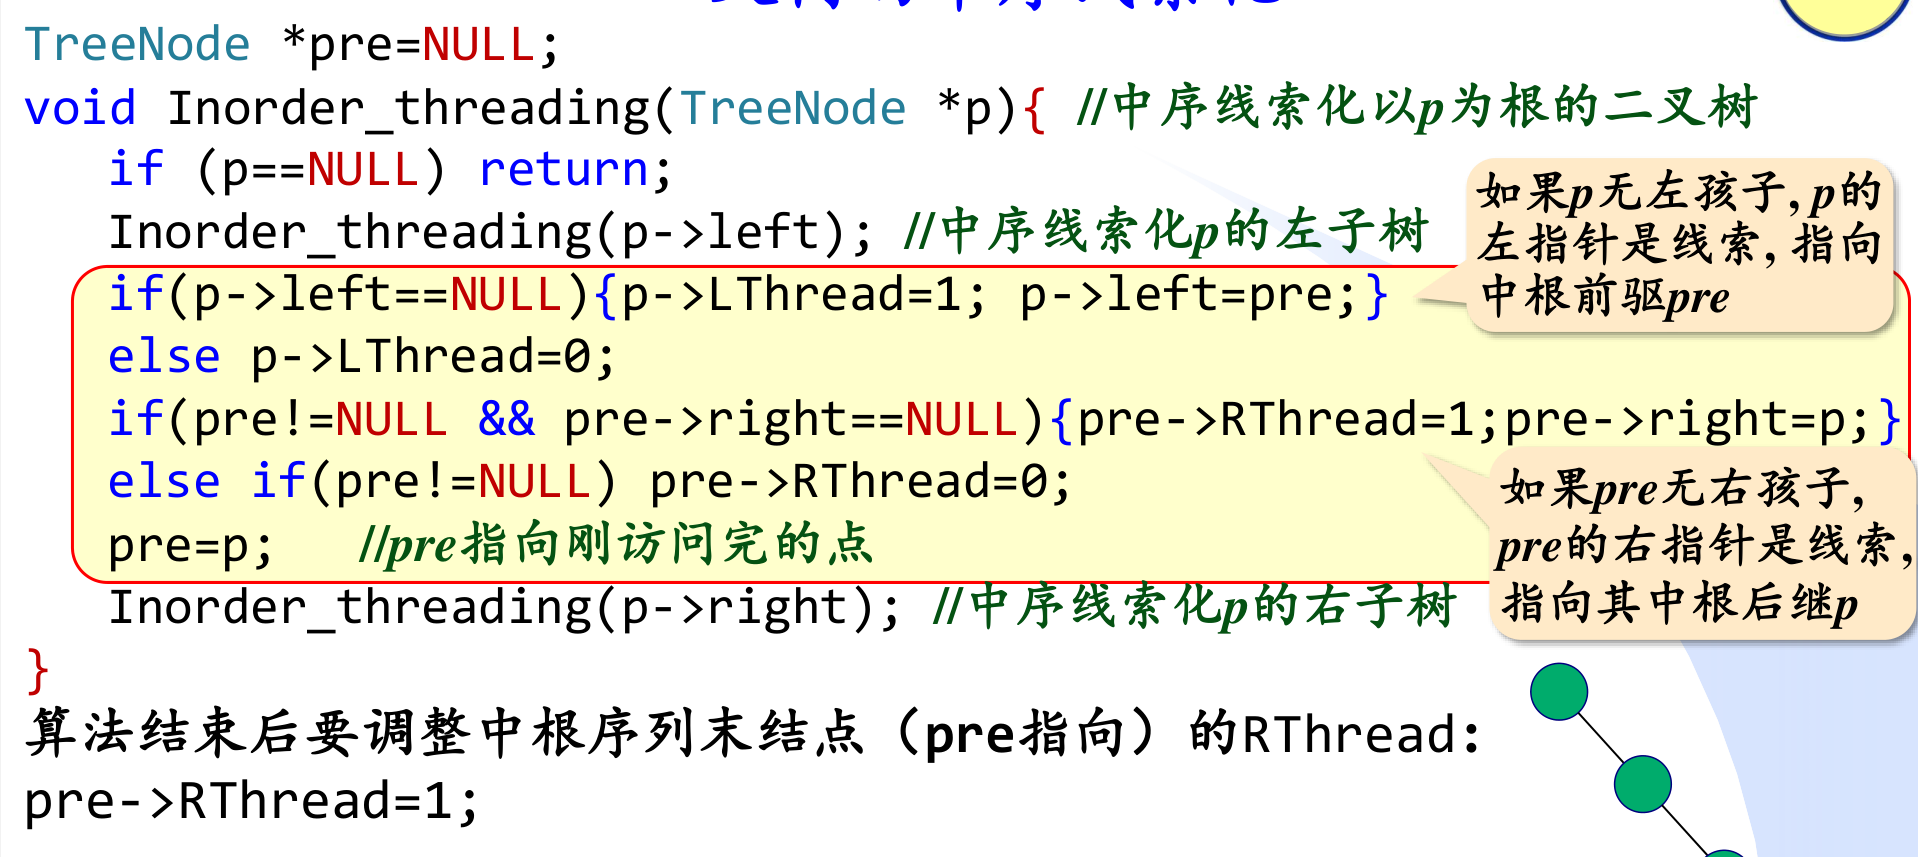
若结点结构中没有父指针: 前序线索二叉树不能解决高效查找结点的先根前驱的问题 后序线索二叉树不能解决高效查找结点的后根后继的问题
哈夫曼树
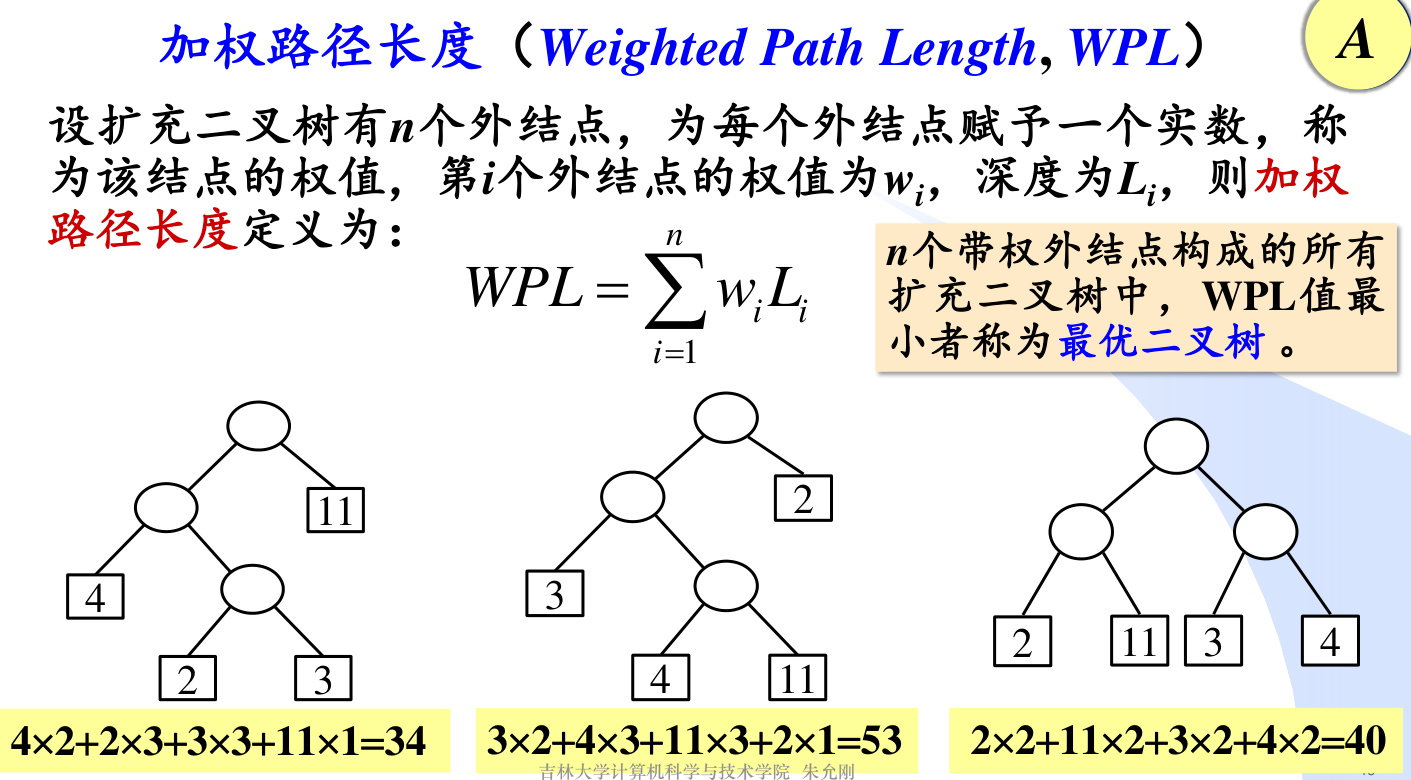
最优合并代价问题
= 构造一棵二叉树,使内部节点和最小
= 最优编码问题 = 从底向上合并叶子,每次合并两个最小值
= Huffman Tree 的构造方法
Huffman 的贪心策略保证: 深度大的都是小的叶子
深度小的都是大的叶子
因此总代价最小。
Huffman算法/哈夫曼树的构建
每次从当前剩余的权值中选两个最小的合并成新节点,再放回集合,重复直到只剩一个(自下而上的构建Huffman树) 最小堆(priority_queue 或 heap)——是最优方法
哈夫曼编码
霍夫曼编码就是一种变长编码方案,它借助二叉树结构构造变长编码,能够确保解码的唯一性,同时兼顾压缩效果和性能。
对哈夫曼树每个非叶结点的左分支标记0,右分支标记1。 ➢把从根到叶的路径上的标号连接起来,作为该叶结点所代表的字符的编码。
表达式树
根据后缀表达式构造表达式二叉树: 从左向右扫描后缀表达式,每扫描到一个符号就生成一个结点, 该符号作为结点的数据域值,若扫描到的符号是: ➢操作数:将此操作数结点压栈。 ➢运算符:从栈中弹出两个结点,分别作为当前运算符结点的右、左孩子,再将当前运算符结点压栈。 ➢表达式扫描完成后,栈顶即为表达式二叉树的根结点
二叉堆
满足 堆序性质(heap-order property) 的完全二叉树 二叉堆把元素先放在数组末尾是为了保持完全二叉树的结构,然后通过上浮或下沉修复堆序性。 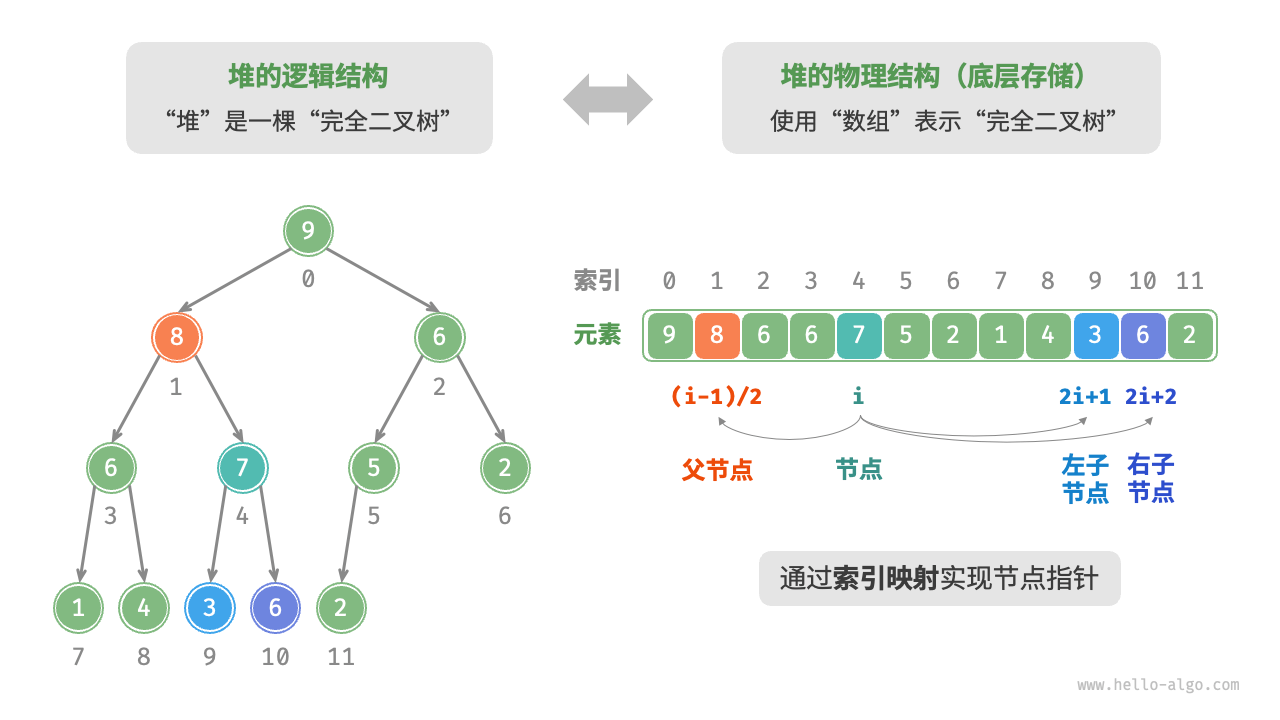
上浮用于“新人进场”,下沉用于删除堆顶元素和构建堆(Heapify)
堆排序
第一阶段: Floyd/筛选法/初始建堆法——从第一个非叶子节点到上 通过shift down/下沉操作 进行堆化 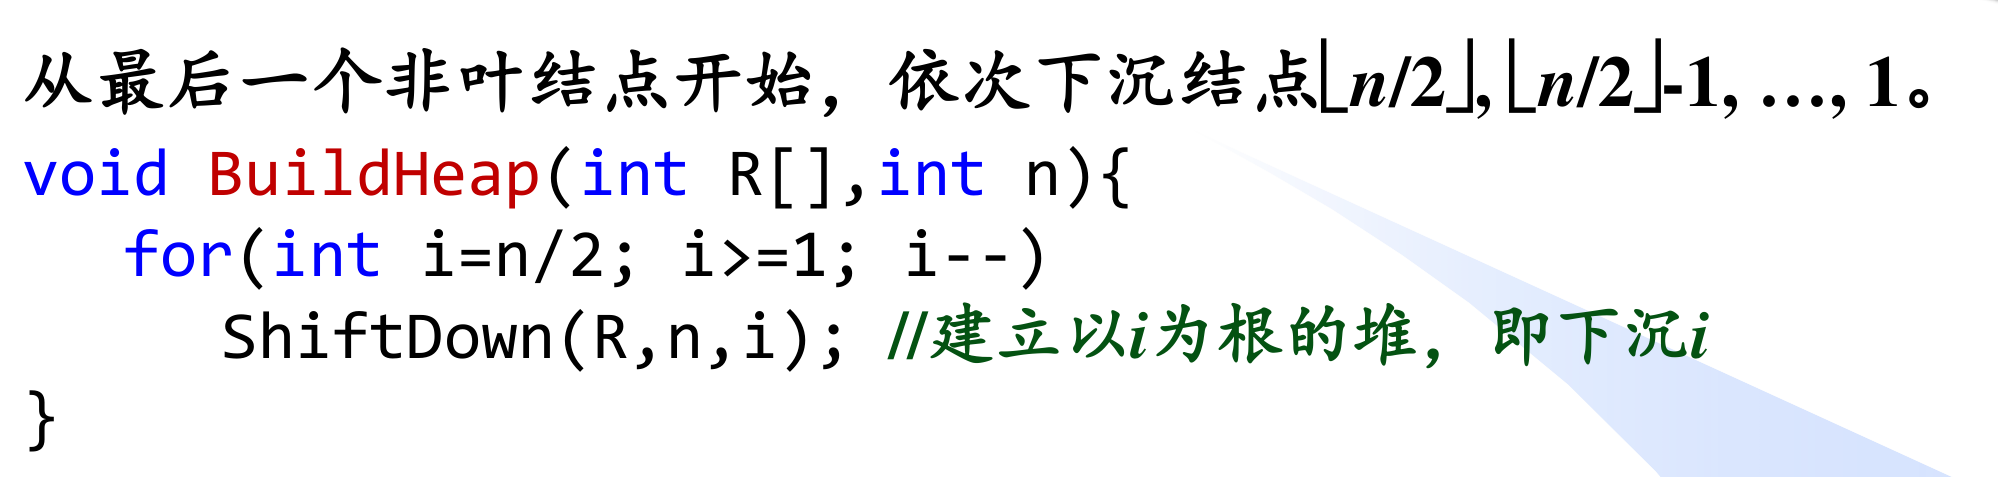
- 将列表所有元素原封不动地添加到堆(数组)中,此时堆的性质尚未得到满足。
- 倒序遍历堆(层序遍历的倒序),依次对每个非叶节点执行“从顶至底堆化”。
// ---大顶堆下沉 ---
// arr 是一个假装从 1 开始的局部数组,size 是数组长度
void siftDown(int *arr, int size, int node) {


    // 对于 1-based 数组,只要 2 * node <= size,就说明有左孩子,可以继续比较
    while (node * 2 <= size) {


        int left = node * 2;
        int right = node * 2 + 1;
        int max_node = node; // 记录父节点、左孩子、右孩子中最大的那个

        // 比较左孩子
        if (left <= size && arr[left] > arr[max_node]) {


            max_node = left;
        }
        // 比较右孩子
        if (right <= size && arr[right] > arr[max_node]) {


            max_node = right;
        }
        // 如果最大的是自己,说明已经满足堆的性质,下沉结束
        if (max_node == node) {


            break;
        }

        // 交换父节点和最大的孩子
		swap(arr[node],arr[max_node])
        // 继续往下层走
        node = max_node;
    }
}
第二阶段: 排序,不断弹出堆顶元素。 最简单的堆排序算法思路就是直接利用优先级队列,把所有元素塞到优先级队列里面,然后再取出来,但是原地排序的“Pop”技巧:
- Top-k 是一个经典算法问题,可以使用堆数据结构高效解决,时间复杂度为O(nlogk)。
- 最小堆显然不唯一
- 堆排序时间复杂度2NlogN 空间复杂度是 O(1)
- 堆排序是一种不稳定的排序算法,因为二叉堆本质上是把数组结构抽象成了二叉树结构,在二叉树逻辑结构上的元素交换操作映射回数组上,无法顾及相同元素的相对位置。
优先级队列
优先级队列是逻辑上的接口(ADT,抽象数据类型),而二叉堆是实现这个接口最佳的数据结构
优先级队列插入元素时,首先把元素追加到二叉堆底部,然后调用 swim 方法把该元素上浮到合适的位置,时间复杂度是 O(logN)
优先级队列删除堆顶元素时,首先把堆底的最后一个元素交换到堆顶作为新的堆顶元素,然后调用 sink 方法把这个新的堆顶元素下沉到合适的位置,时间复杂度是 O(logN)
AVL树/平衡二叉树
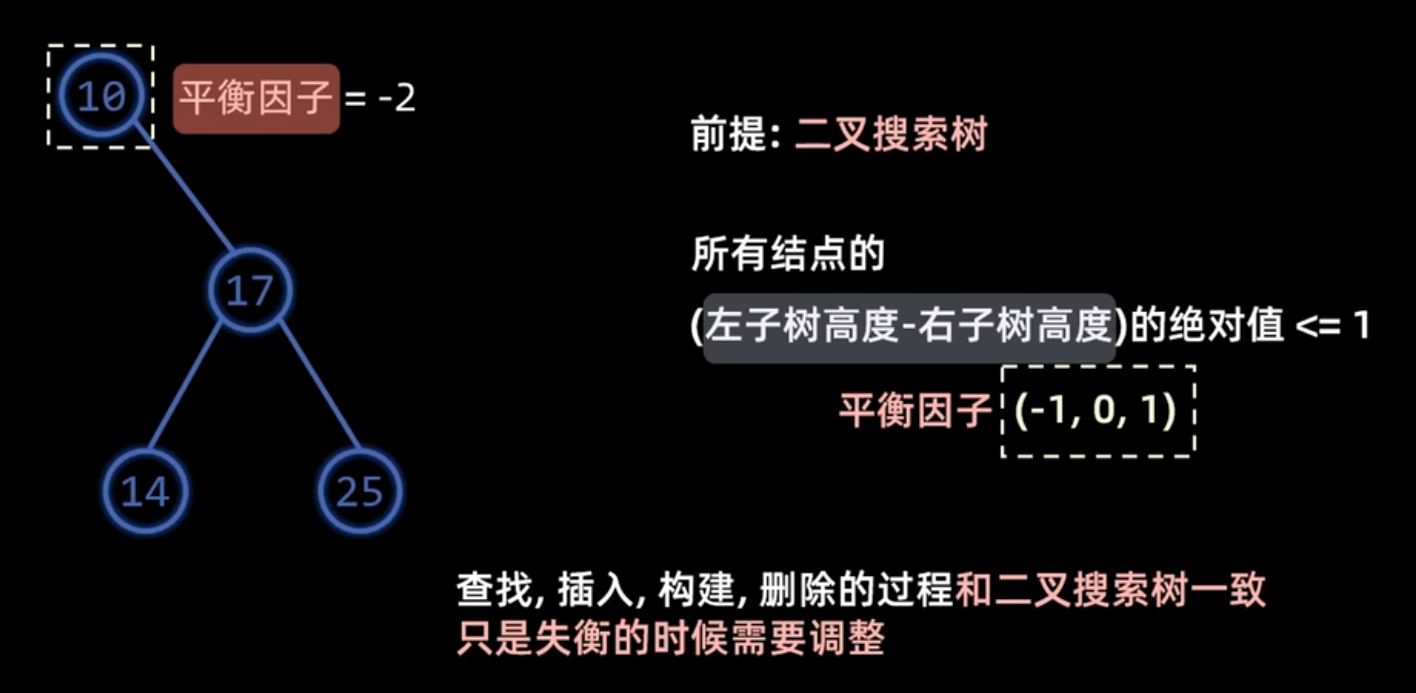
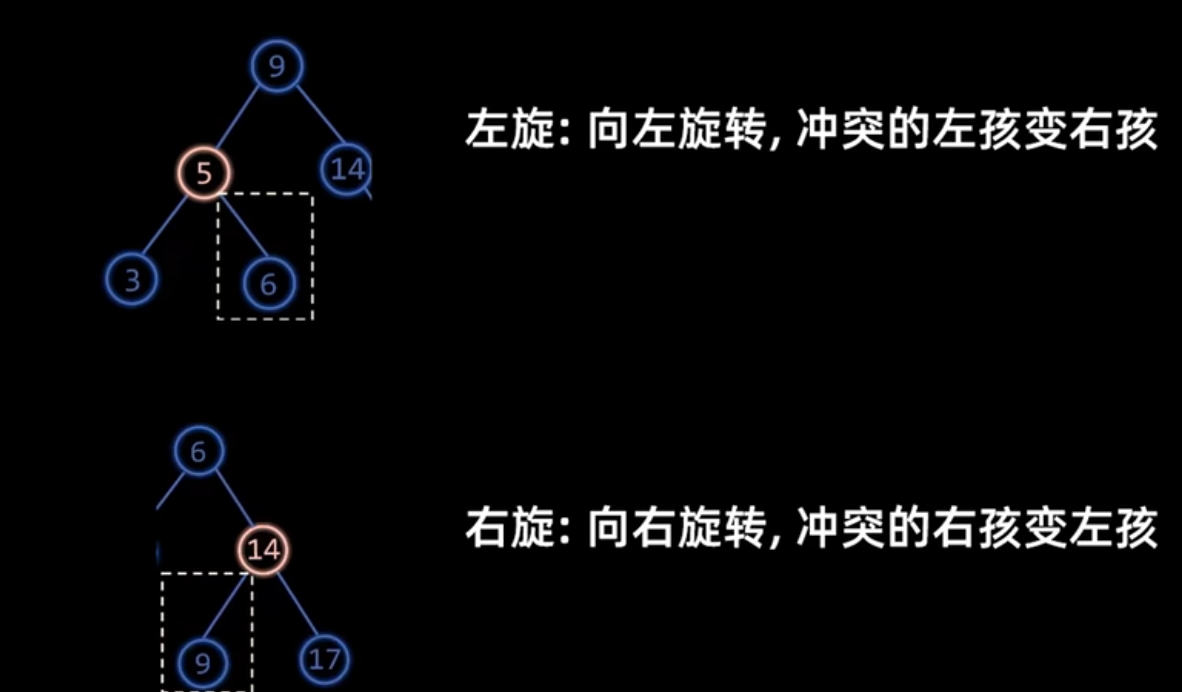
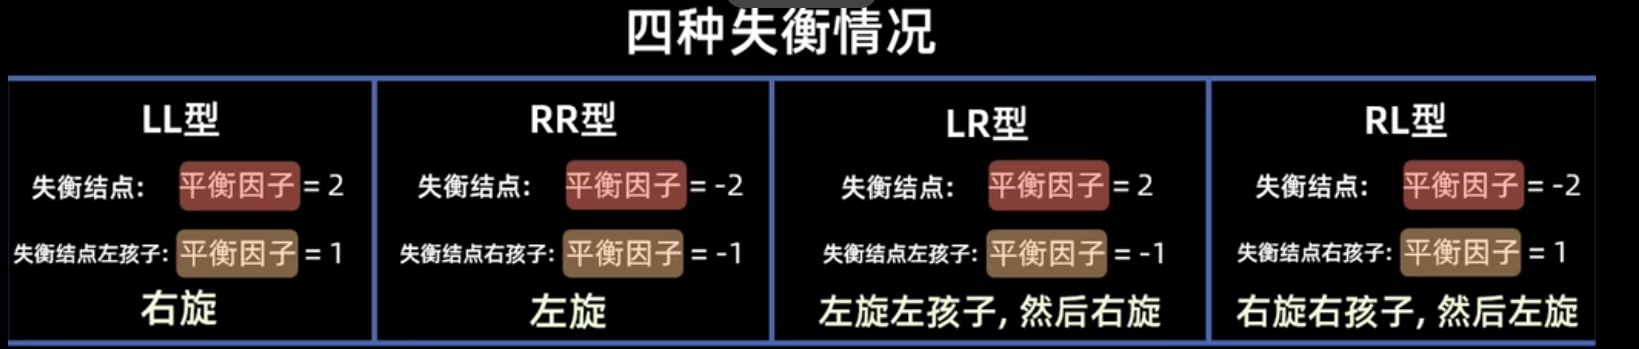
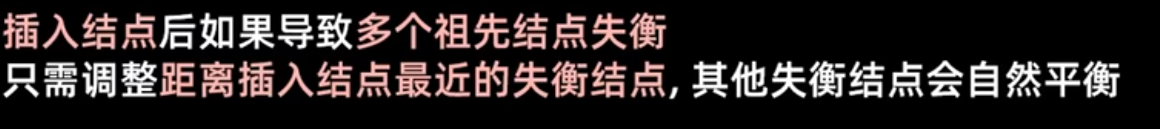
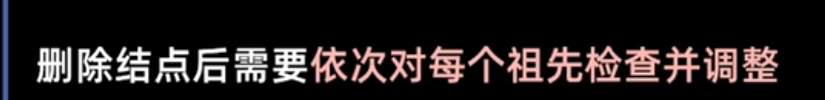
➢AVL树的高度为O(logn),因此使插入、删除、查找的最坏 时间复杂度均为O(logn)。 ➢删除操作最坏情况下需要做O(logn)次旋转
多叉树
N/多叉树 遍历
唯一的区别是,多叉树没有了中序位置
// N 叉树的遍历框架
void traverse(Node root) {


    if (root == null) {


        return;
    }
    // 前序位置
    for (Node child : root.children) {


        traverse(child);
    }
    // 后序位置
}
存储结构
顺序存储——双亲表示法
链接存储——多叉链表(孩子链) 每个结点的指针数以整棵树中孩子最多的结点为准,大量指针为空
链接存储——左孩子-右兄弟(LCRS)链接结构
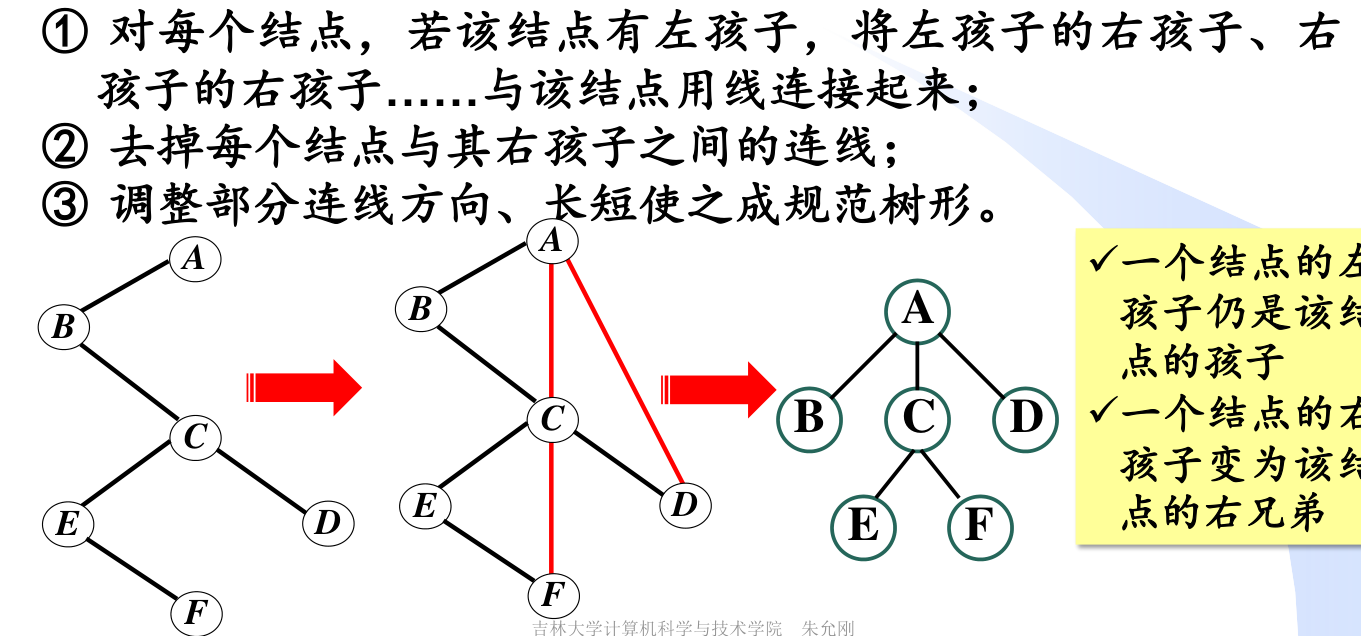
树、森林、二叉树相互转换
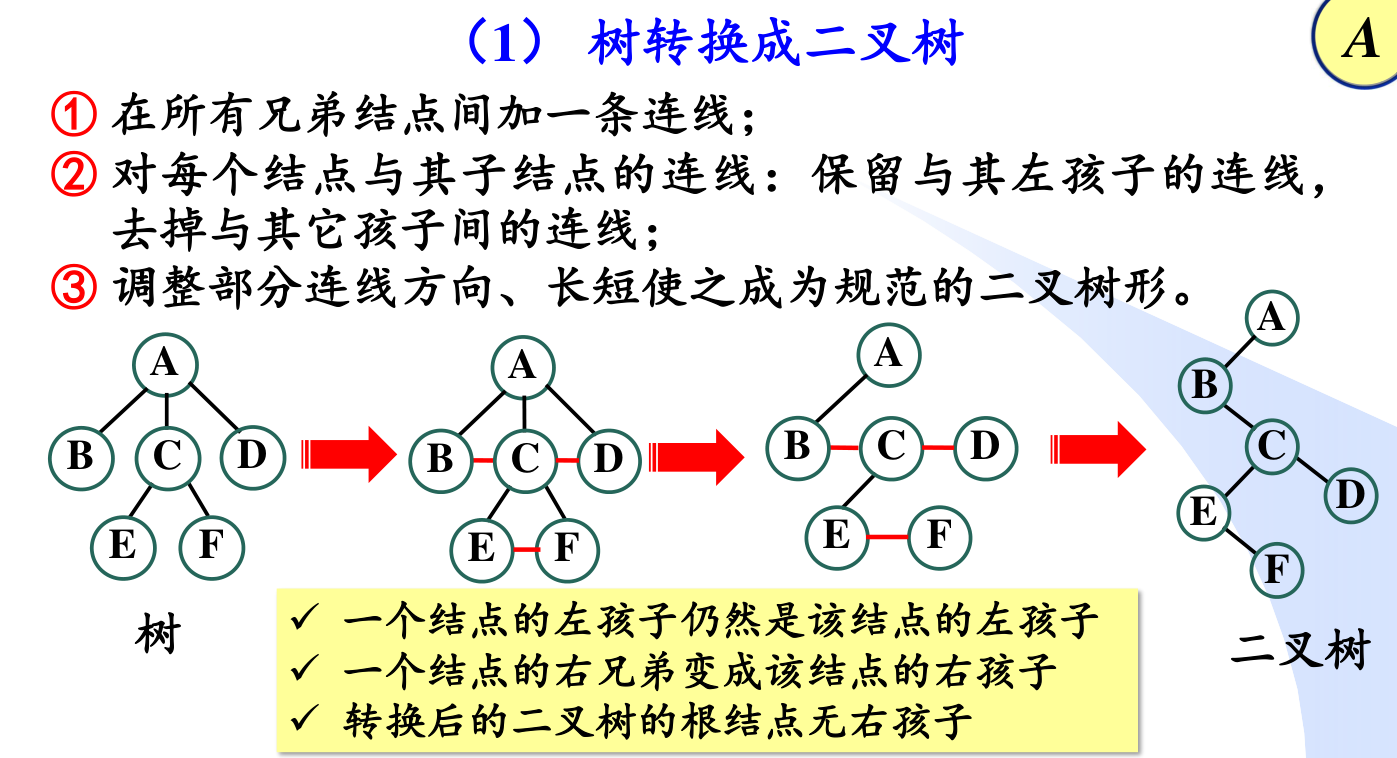
- 多叉树转换成二叉树
-
森林转换成二叉树 引入一个虚拟的根,将森林转变为多叉树
-
二叉树转换成树 前提:二叉树的右子树为空,则可转换为一棵树
-
二叉树转换成森林 ① 从根出发,断开其与右孩子的连线,得到多个二叉树; ② 将每个二叉树按以上方法转化为树
遍历关系
多叉树没有“中序遍历”,会遇到歧义:根节点应该插在第几个子节点之后?
- 是放在第1个子节点之后?( C h i l d _ 1 t o R o o t t o C h i l d _ 2 d o t s C h i l d _ N Child\_1 \\to Root \\to Child\_2 \\dots Child\_N Child_1toRoottoChild_2dotsChild_N)
- 还是放在中间位置?(如果 N = 3 N=3 N=3,是 C h i l d _ 1 t o C h i l d _ 2 t o R o o t t o C h i l d _ 3 Child\_1 \\to Child\_2 \\to Root \\to Child\_3 Child_1toChild_2toRoottoChild_3 吗?)
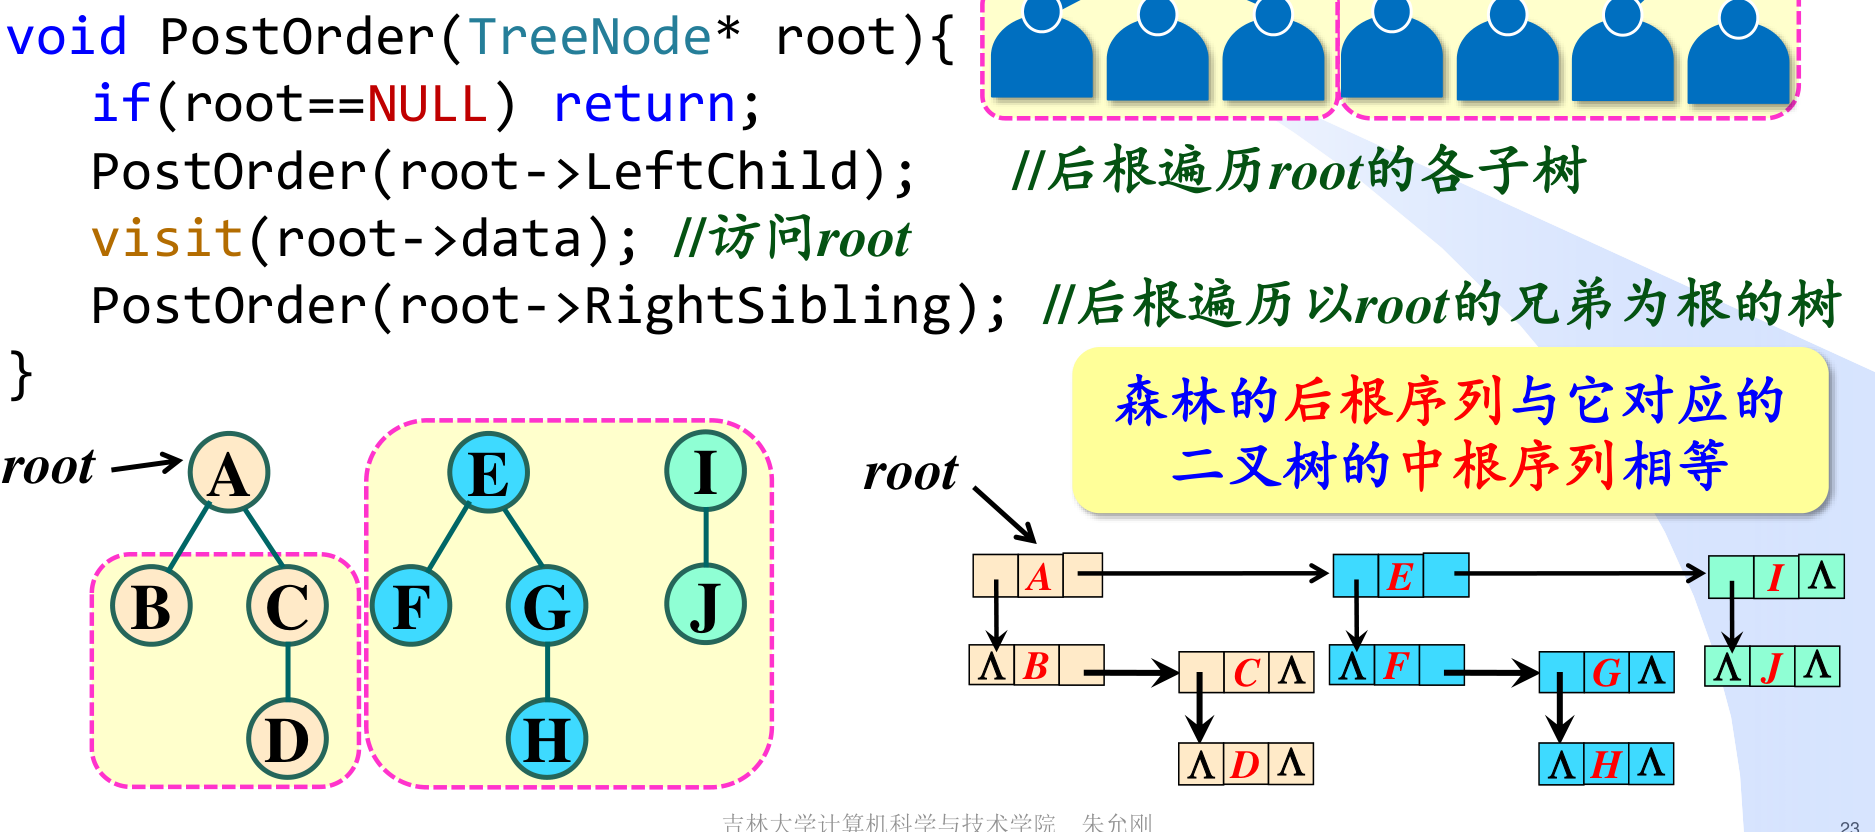
| 遍历逻辑 | 树 (Tree) | 森林 (Forest) | 对应的二叉树 (Binary Tree) |
|---|---|---|---|
| 先访问根 | 先根遍历 (Preorder) | 先序遍历 (Preorder) | 先序遍历 (Preorder) |
| 后访问根 | 后根遍历 (Postorder) | 后根序列(Inorder) | 中序遍历 (Inorder) |
 |
平衡树
B树(B-树)
AKA 多叉平衡搜索树
m阶b树 根以外的结点:有 【𝒎/𝟐 −𝟏, 𝒎−𝟏 】个关键词(向上取整) 有k个孩子的结点恰好包含k-1个递增有序的关键词 反之必然成立 3阶b树 则其他结点至少1个k 2个孩子
B树的插入:上溢→分裂
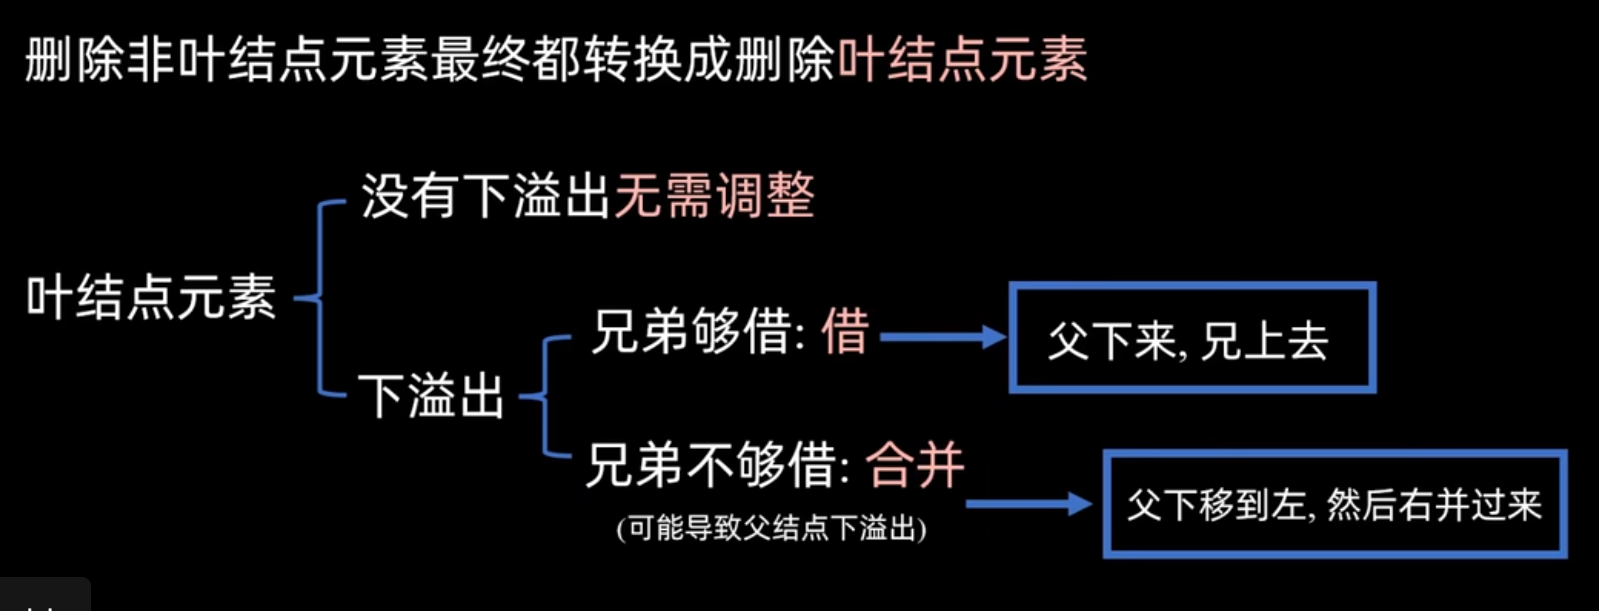
B树的删除:下溢→借位 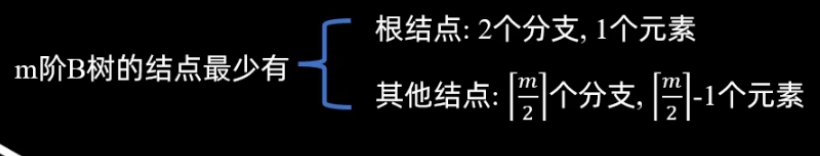
B+树 多路平衡树
节点中的指针数 = 键数 + 1
- 数据只存在于叶子节点
- 叶子节点相互连接
- 索引节点是冗余的 索引节点中的键同时也会出现在叶子节点中
Splay树
红黑树
是一种经典的自平衡的二叉树
Trie树/字典树
TrieNode 节点本身只存储 val 字段,并没有一个字段来存储字符,字符是通过子节点在父节点的 children 数组中的索引确定的
形象理解就是,Trie 树用「树枝」存储字符串(key),用「节点」存储字符串(key)对应的数据(val)。所以我在图中把字符标在树枝,键对应的值 val 标在节点上: 这里空节点没有画
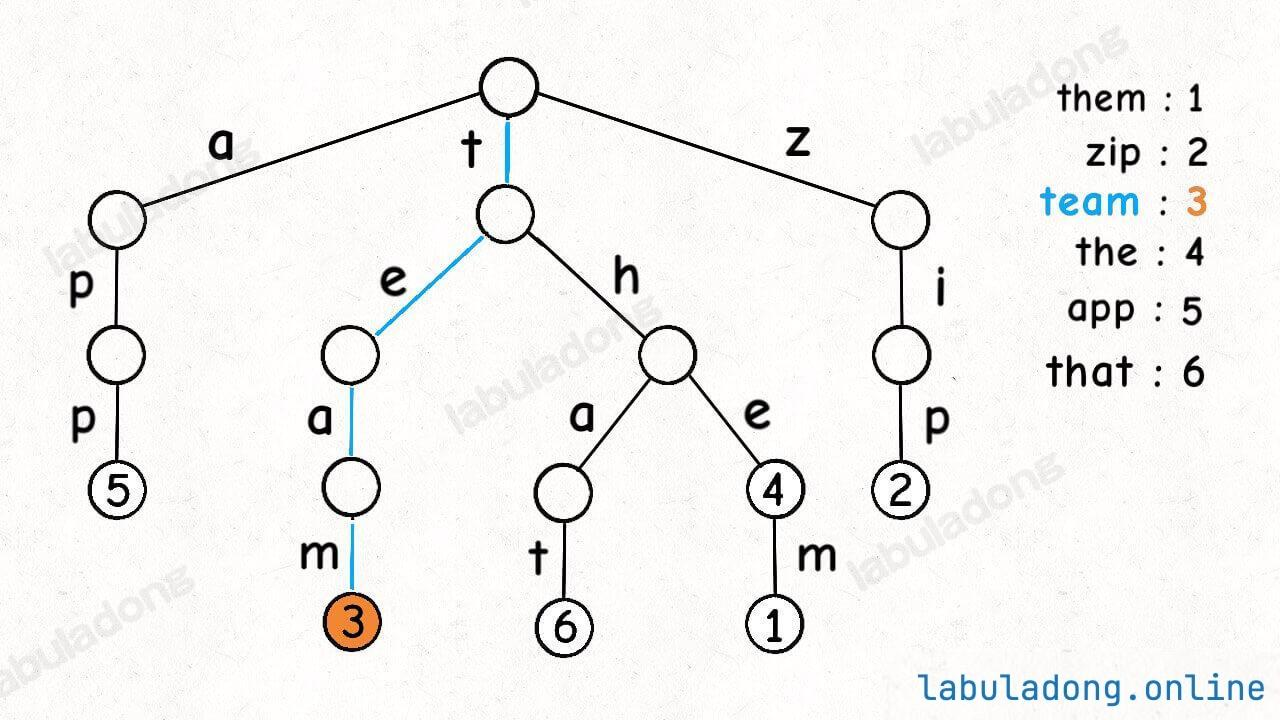
一个节点非null 只能说他是一个prefix 不能确定是不是一个key
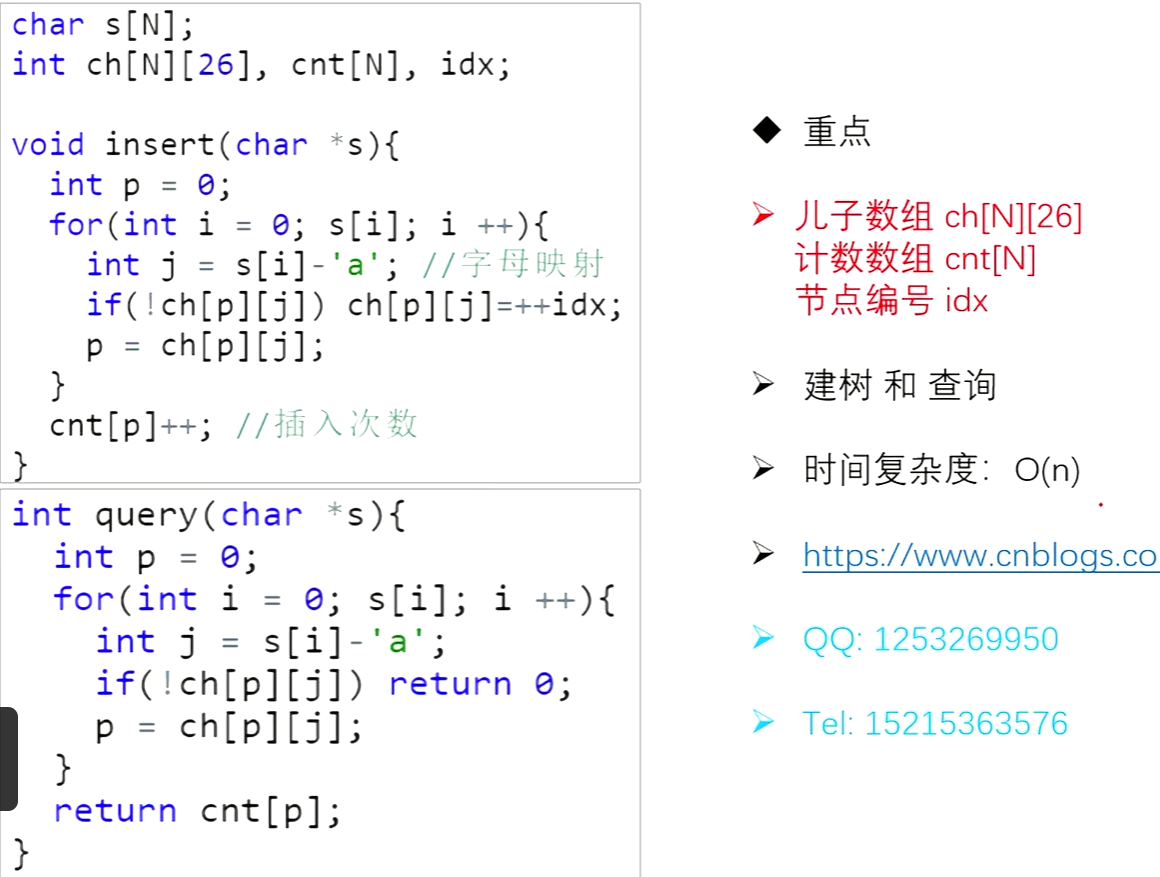
cnt[p] 统计的是“以该节点为结尾的单词个数” 每次被赋值后,p 就指向当前处理到的节点/p = 当前在 Trie 树上的位置
图
概念
不含重边和自环的图称为简单图,以下默认都是简单图 完全图: 有向完全图:任意两个顶点之间都有方向相反的两条边。包含n个顶点的有向完全图中,有n(n-1)边 度: 有向图顶点的度=入度+出度 度与边的关系: 任意图 顶点的度数之和就是边的2倍 故已知顶点的度序列,即可求出边的条数 子图: 图G的子图就是从G中抽取一部分顶点或边构成的图 如果H是G的子图,并且V(H) =V(G),则称H为G的支撑子图。
连通性
无向图连通性: 连通分量 (Connected Component):对于非连通的无向图,其中的多个连通子图被称为连通分量,一个图可以有多个连通分量。无向图G的连通分量即为G的极大连通子图 有向图连通性: 强连通图 (Strongly Connected Graph):如果有向图中任意两个节点之间都存在一条有向路径,我们称这个图是强连通的。 弱连通图 (Weakly Connected Graph):如果将有向图中的所有有向边都变成无向边后,该图变成连通的,那么原来的有向图就是弱连通的。 强连通分量 (Strongly Connected Component, SCC):有向图中的若干个最大的强连通子图称为强连通分量。
图的存储
邻接矩阵
无向图的邻接矩阵是对称矩阵,有向图邻接矩阵不一定对称。
➢ 空间:O(n^2) ➢ 判断图中是否包含某条边(Vi , Vj): O(1) ➢ 找某个点的邻接顶点: O(n) ➢ 缺点:存储稀疏图(点多边少),邻接矩阵为稀疏矩阵,浪费空间和时间。
邻接表
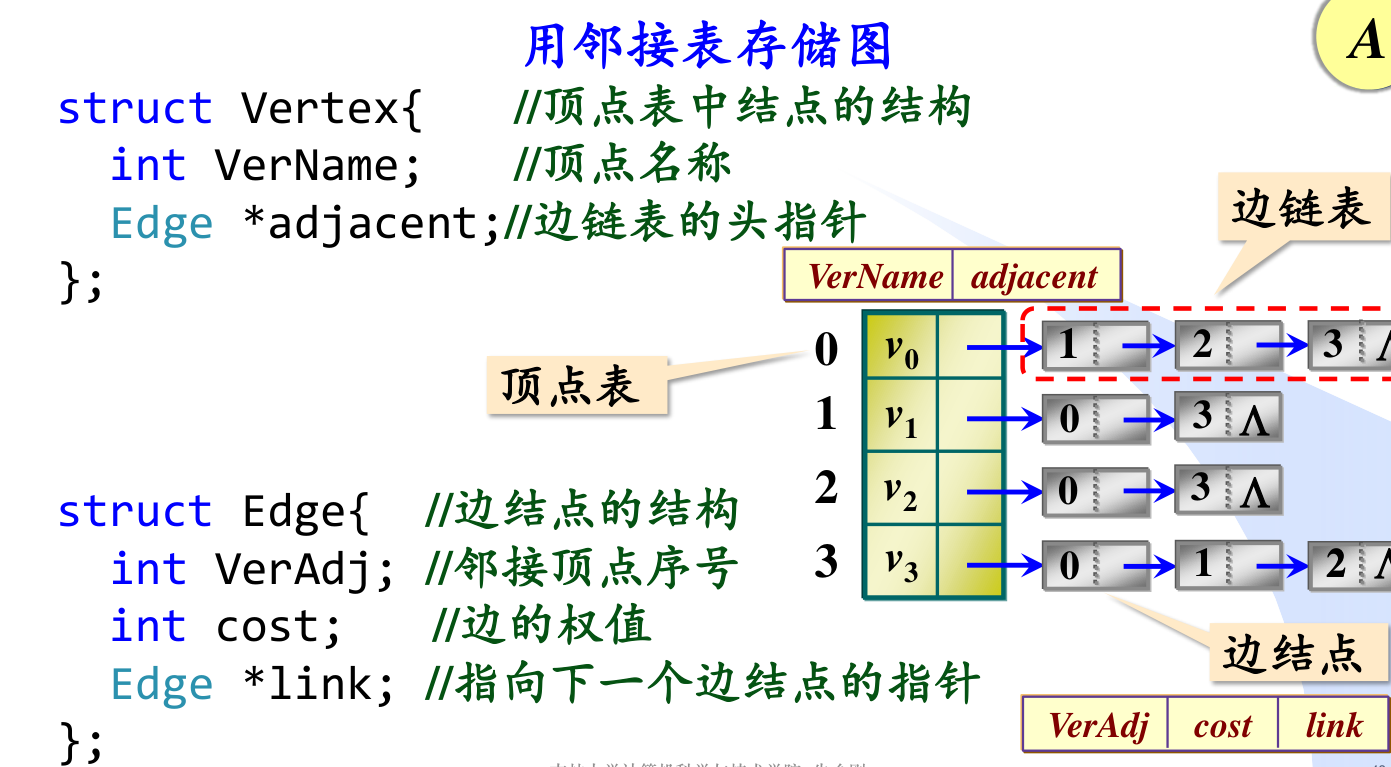
前向星和链式前向星
图的遍历
类比多叉树的遍历
dfs
是顶点出”栈“时访问
遍历所有节点(visited 数组)
// 图的dfs遍历框架
// 需要一个 visited 数组记录被遍历过的节点,避免走回头路陷入死循环
void traverse(Vertex* s, std::vector<bool>& visited) {


    // base case
    if (s == nullptr) {


        return;
    }
    if (visited[s->id]) {


        // 防止死循环
        return;
    }
    // 前序位置
    visited[s->id] = true;
    std::cout << "visit " << s->id << std::endl;
    for (auto neighbor : s->neighbors) {


        traverse(neighbor, visited);
    }
    // 后序位置
}
二维visited 数组用于遍历所有边
visited[u][v] 表示边 (u->v 已经被遍历过),从而确保每条边只被遍历一次。
遍历所有路径(onPath 数组)
visited 数组和 onPath 分别用于遍历所有节点和遍历所有路径,关键区别在于后序位置撤销 onPath 数组标记(遍历所有路径是回溯问题)
onPath[src] = true;
path.push_back(src);
for (const Edge& e : graph.neighbors(src)) {


	 traverse(graph, e.to, dest);
}
path.pop_back();
onPath[src] = false;
遍历所有路径的算法复杂度较高,大部分情况下我们可能并不需要穷举完所有路径,而是仅需要找到某一条符合条件的路径。这种场景下,我们可能会借助
visited数组进行剪枝,提前排除一些不符合条件的路径,从而降低复杂度
有向无环图(DAG) 是不用 visited 数组,也不用 onPath 数组的场景
bfs
顶点入队时访问标记、判重(如果是出队时再判重 会导致队列里面出现重复节点)
// 图结构的 BFS 遍历,从节点 s 开始进行 BFS
void bfs(const Graph& graph, int s) {


    vector<bool> visited(graph.size(), false);
    queue<int> q;
    q.push(s);
    // 记录当前遍历到的层数(根节点视为第 1 层)
    int depth = 1;
    visited[s] = true;

    while (!q.empty()) {


        int cur = q.front();
        q.pop();
        // 访问 cur 节点,同时知道它所在的层数
        cout << endl;
        for (const Edge& e : graph.neighbors(cur)) {


            if (visited[e.to]) {


                continue;
            }
            visited[e.to] = true;
            q.push(e.to);
        }
        depth++;
    }
}
实际上 BFS 算法一般只用来寻找那条最短路径,不会用来求所有路径
并查集
带路径压缩就差不多了 按rank合并已无太大不要 ➢单独使用按秩合并或路径压缩,Union和Find操作的均摊时 间复杂度为O(logn). ➢定理:一组m个Make_Set、Union和Find操作的序列,其中 Make_Set操作的个数为n,在不相交集合上同时使用按秩合 并与路径压缩,最坏情况时间复杂度为O(m α(n)) . ➢上述定理表明:同时使用按秩合并和路径压缩两种优化策略, 每个操作的均摊时间复杂度接近O(1) .
int find(int x){


    //这步就是路径压缩,让每个结点的上一个结点为该集合根节点
    if (fa[x] != x) fa[x] = find(fa[x]);
    return fa[x];
}
最短路
- 单源最短路径
- BFS 无权图的最短路 时间复杂度: O ( V + E ) O(V+E) O(V+E)
2. Dijkstra 算法
其本质是标准 BFS 算法 + 贪心思想 如果图中包含负权重边,会让贪心思想失效,所以 Dijkstra 只能处 理不包含负权重边的图。
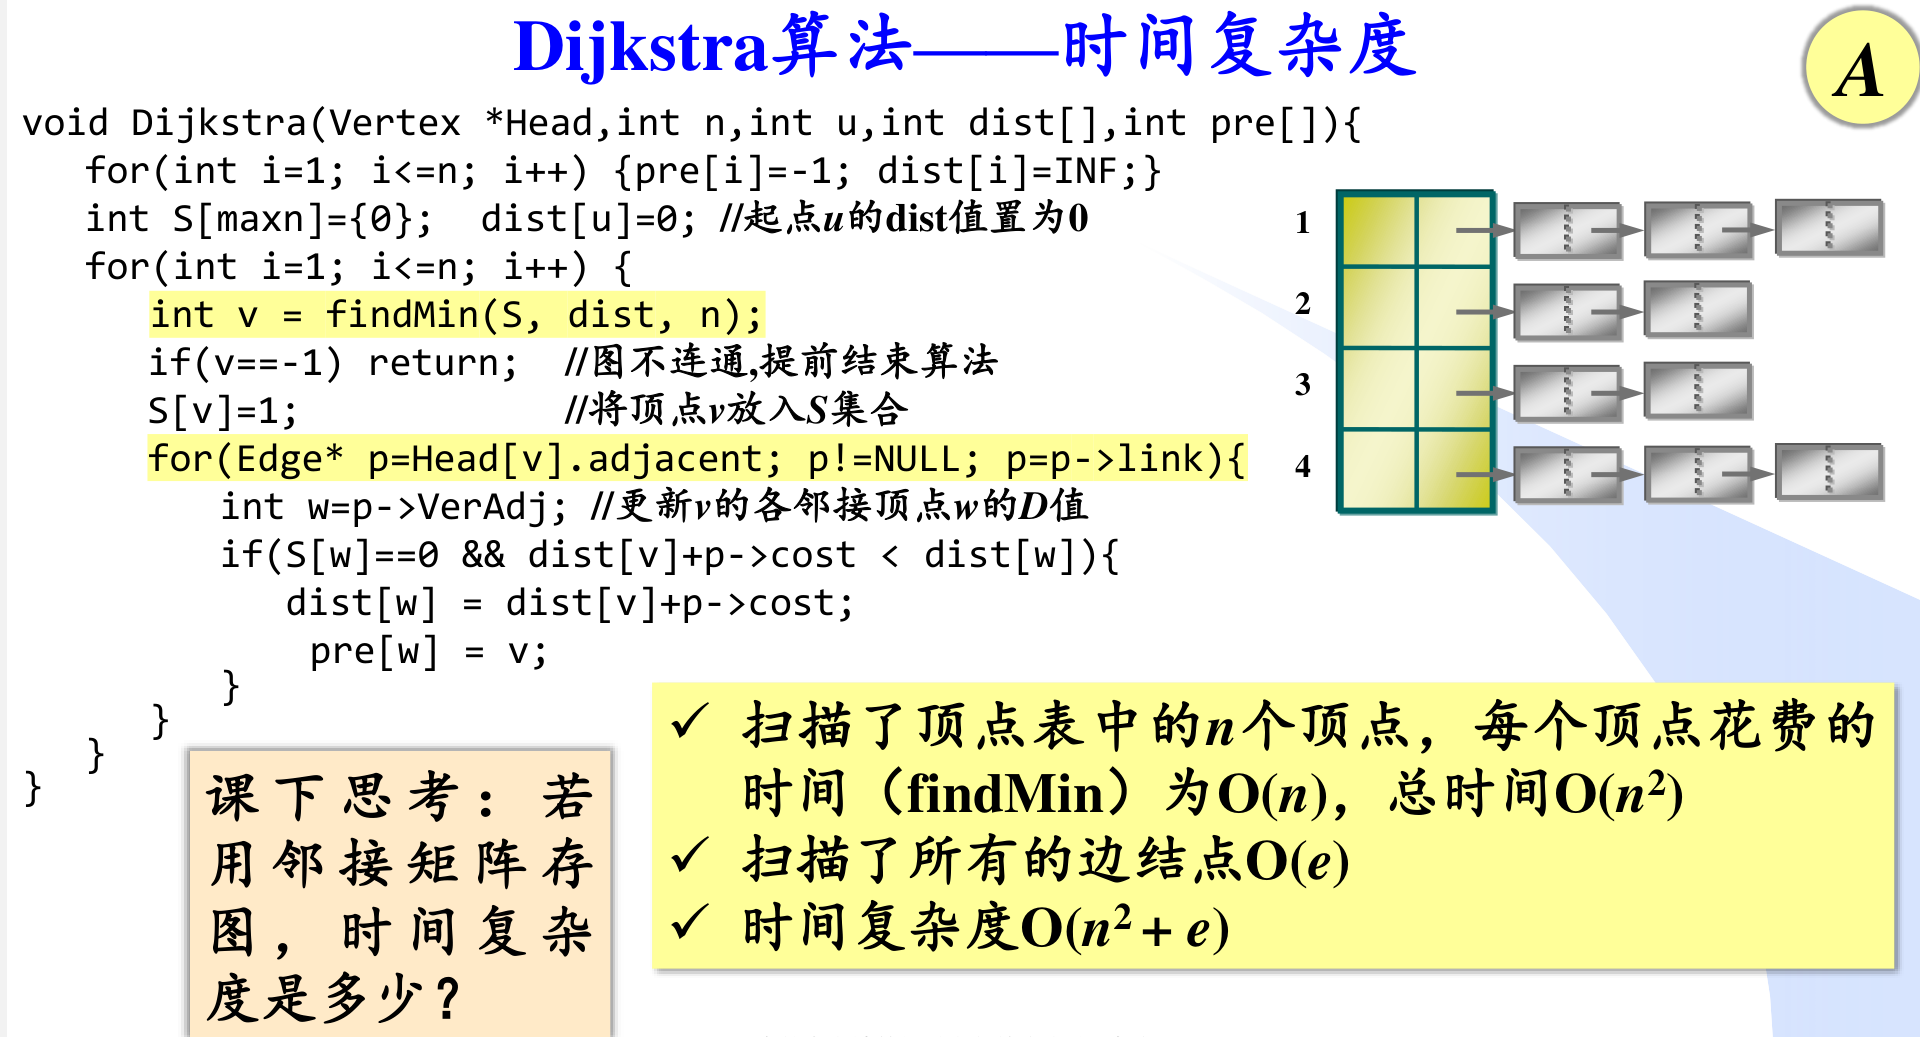
时间复杂度:堆优化版: O ( E l o g V ) O(E \\log V) O(ElogV)
distTo[v]
表示:目前已知的、从起点到 v 的最小路径长度
- 用
distTo数组替代visited数组,入队的时候更新distTo - 要在元素出队时进行剪枝,因为Dijkstra 算法的队列中可能有重复的节点,出队不一定是最短路径
const int INF=0x3f3f3f3f;
int n,m,s;
typedef struct Edge{


    int to,w;
}Edge;
vector<vector<Edge>> graph;
using pli = pair<long long, int>;
vector<long long> distTo;
vector<int> cities;
void dijkstra(int start){


    for(int i=1;i<=n;i++) {


        distTo[i] = INF;
        cities[i] = 0;
    }//初始化准备
    priority_queue<pli,vector<pli>,greater<pli>> minpq;
   //最小堆

   //开始
    minpq.push({

      0,s});
    distTo[s] = 0;

    while(!minpq.empty()){


        auto [curDist, u] = minpq.top();
        minpq.pop();

        if (curDist > distTo[u]) continue;
        for (auto &edge : graph[u]) {


            int v = edge.to;
            long long nextDist = curDist + edge.w;
            // 找到更短路径
            if (nextDist < distTo[v]) {


                distTo[v] = nextDist;
                // ⭐ 核心:路径节点数从 u 继承
                cities[v] = cities[u] + 1;
                minpq.push({

      nextDist, v});
            } else if (nextDist == distTo[v]) {


                // ⭐ 二级目标:在最短距离下,取经过节点更多的
                    if (cities[u] + 1 > cities[v]) {


                        cities[v] = cities[u] + 1;
                        // ⚠️ 注意:不需要再 push,因为 dist 没变
                    }
            }
        }
    }
}
Dijkstra 算法可以同时适用于有向图和无向图,而 Prim 算法只能解决无向图中的最小生成树问题
- Bellman-Ford 算法 & SPFA(了解即可) Bellman-Ford 适用场景: 带负权边 的单源最短路,且能检测负权环。 时间复杂度: O ( V E ) O(VE) O(VE) SPFA 本质: Bellman-Ford 的队列优化版。
- 多源最短路径 多源最短路径算法最终得到的输出应该是一个二维数组
dist,dist[i][j]表示从节点i到节点j的最短路径长度 理论上可以对所有节点都调用一次单源最短路径算法,但有些场景用 Floyd 这种多源最短路径算法效率更高
Floyd 算法
使用邻接矩阵 适用图:有向图或无向图、可带权(权可为负但不能有负环) 状态转移方程:KaTeX parse error: Undefined control sequence: \[ at position 3: dp\̲[̲i\]\[j\] = \\mi… 核心思想:看能不能经过中间点 k k k,让 i i i 到 j j j 的距离更短 时间复杂度: O ( V 3 ) O(V^3) O(V3)
可以把 Floyd 的比较改成布尔运算: reachable[i][j] = reachable[i][j] OR (reachable[i][k] AND reachable[k][j]); 这就变成了 Warshall 算法(求传递闭包)。
Floyd–Warshall 的本质不是求最短路径,而是进行动态传递闭包 短路径只是闭包的一种“数值版本”;可达性是闭包的“布尔版本” 闭包就是:把一个集合按照某种规则一直扩张,扩张到不能再扩张为止。
最小树/MST
图的生成树是含有其所有顶点的「无环连通子图」,最小生成树是权重和最小的生成树
求解无向图中最小生成树的经典算法:
Kruskal 算法:
其本质是贪心思想,先对边排序,再借助 并查集 遍历排序后边集合判断是否形成环。
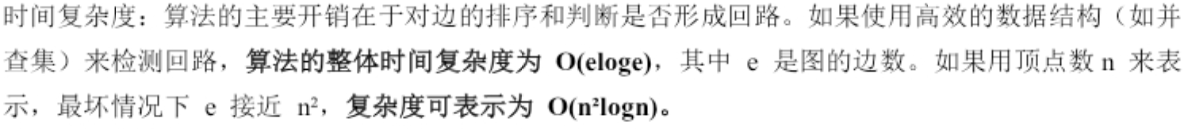
Prim算法:可包含负权重边
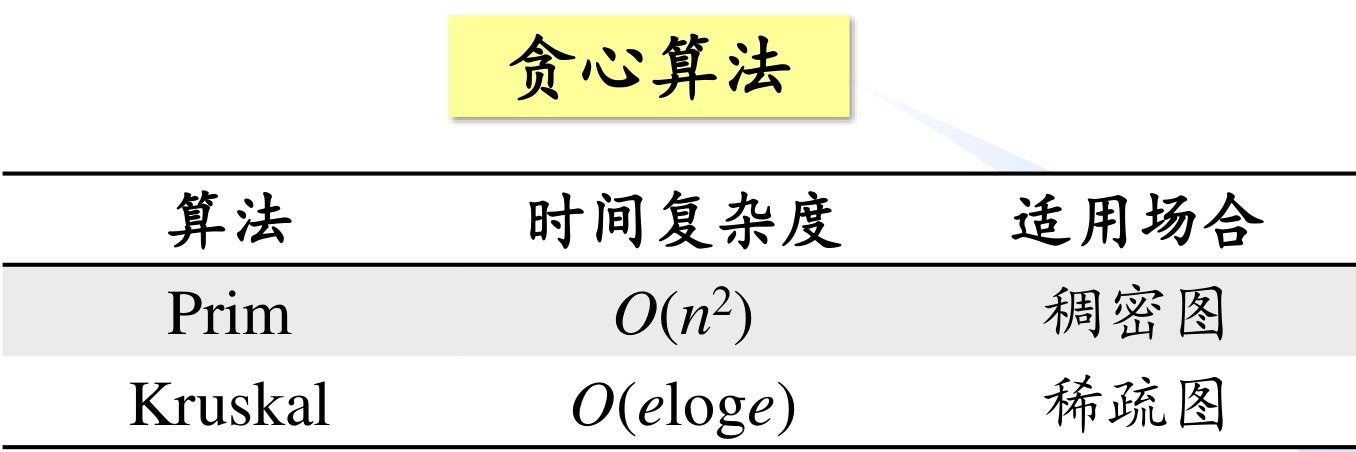
Prim 算法的本质是 BFS + 贪心思想,一边对边排序一边组装最小生成树,相当于 Kruskal 算法先排序后组装的动态过程
只需要对 Dijkstra 算法稍作修改,即可得到 Prim 算法。
切分定理:对于任意一种「切分」,其中权重最小的那条「横切边」一定是构成最小生成树的一条边。或者说:最小跨边一定在某棵最小支撑树里
Prim 算法的时间复杂度通常是 O ( n 2 ) O(n^2) O(n2)(使用邻接矩阵和线性查找最小边时),或者 O ( E l o g V ) O(E \\log V) O(ElogV)(使用邻接表和优先队列优化时)。
强连通分量/SCC
在有向图中,一个 强连通分量 是一个 极大顶点集合,满足:对集合中任意两个顶点互相可达
- Warshall(G, n, R); //R为可及矩阵 + 暴力朴素
- tarjan算法
环检测
无向图判环
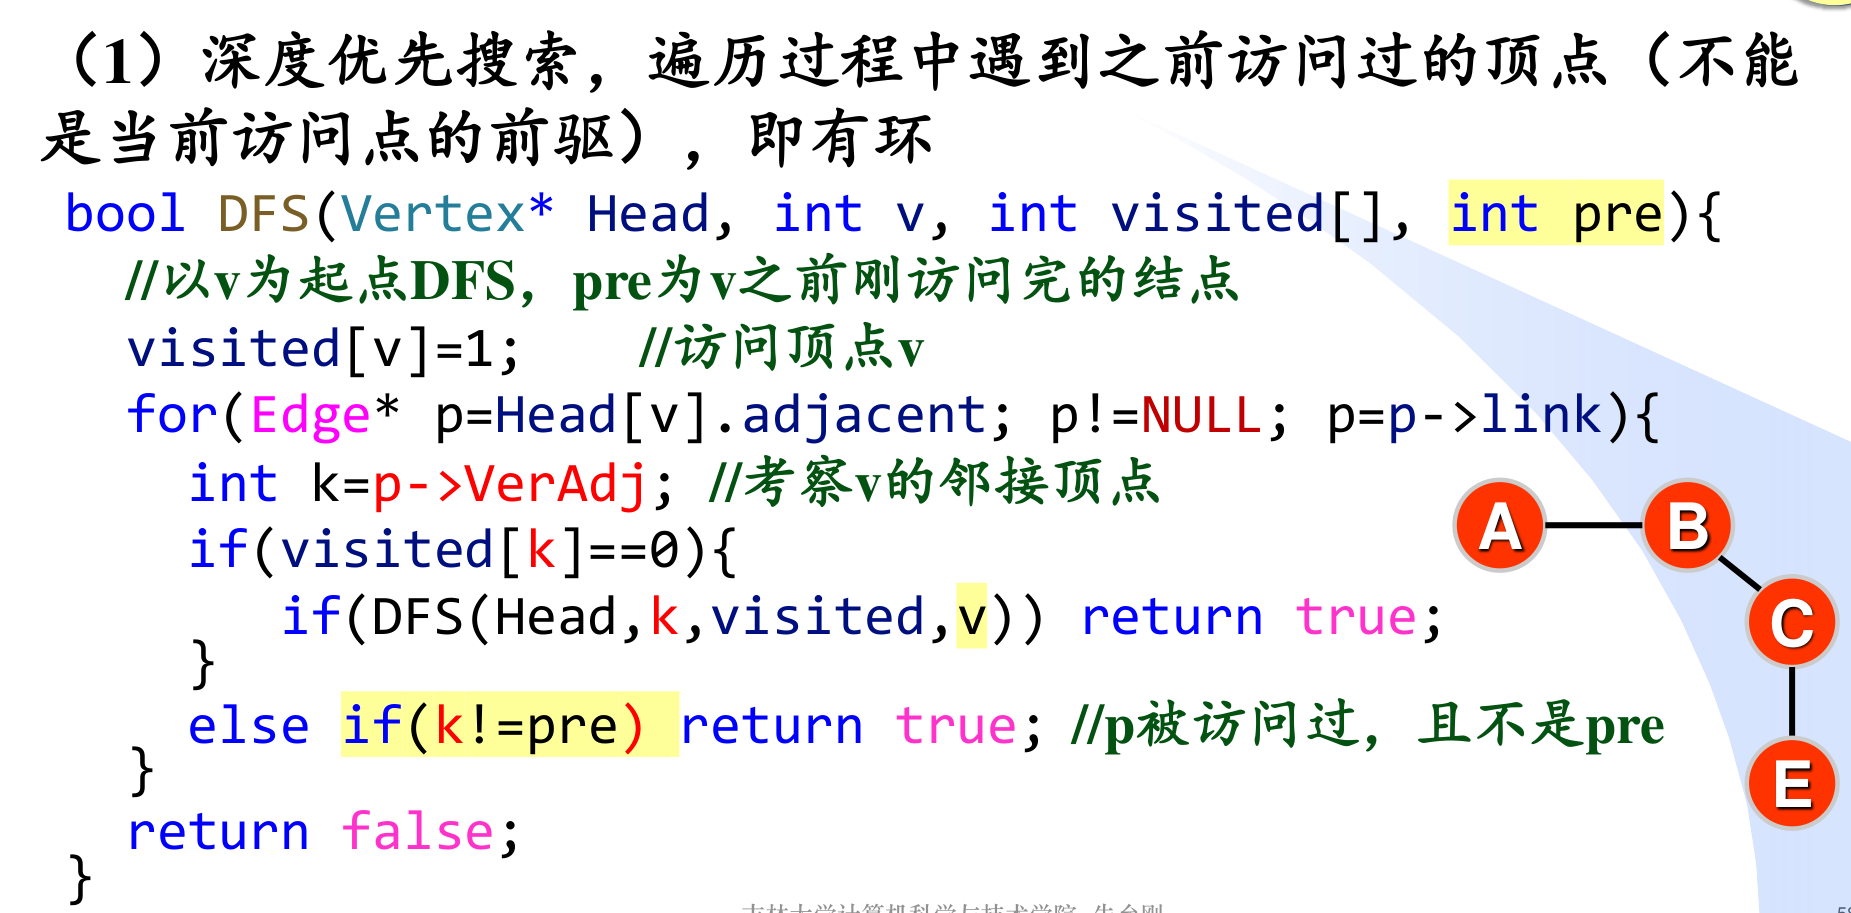
- DFS 算法 在无向图中,边是没有方向的。如果 A A A 和 B B B 连通,意味着既可以从 A A A 到 B B B,也可以从 B B B 到 A A A。 当我们从 A A A 走到 B B B 时,递归进入 B B B 的层级。此时 B B B 的邻接点里肯定包含 A A A。如果不加限制,算法会发现 A A A 已经被访问过,从而误报“有环”(其实只是走回去了)
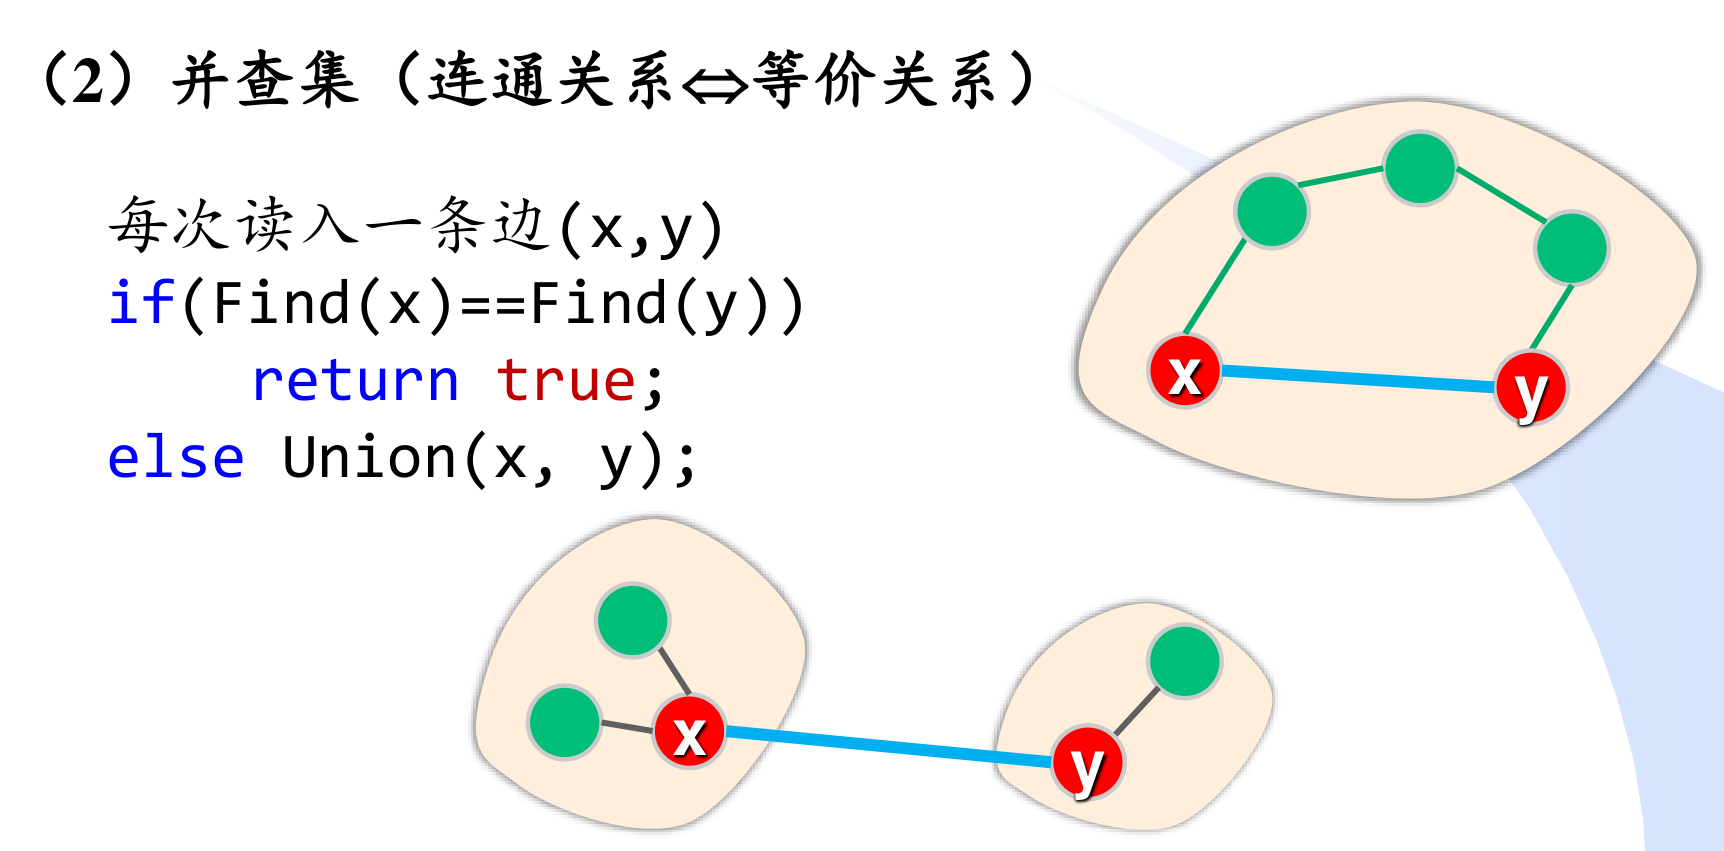
- 并查集
有向图判环
DFS 算法 + onPath 数组
| 状态含义 | 三色标记 (visited int值)** | “双bool数组法” (两个 bool 数组) |
|---|---|---|
| 未访问 | 0 |
visited = false |
| 正在访问 (递归栈中) | 1 |
onPath = true (且 visited 为 true) |
| 访问完成 (安全) | 2 |
visited = true 且 onPath = false |
- 遇到 1 = 有环 (Cycle Detected)。
- 遇到 2 = 无环且已访问 (Safe & Visited),只是单纯的路径汇合(Cross Edge)。
visited(全局访问过):记录哪些节点已经被彻底探索过了。如果一个节点已经标记为true,后续的for循环直接跳过它。onPath(递归路径上):仅记录当前递归栈中的节点,用于检测环。
想要得到组成环的路径,可以在
boolean[] onPath数组的基础上,再使用一个Stack<Integer> path栈,把遍历过程中经过的节点顺序也保存下来
BFS: 1、构建邻接表,和之前一样,边的方向表示「被依赖」关系。 2、构建一个 indegree 数组记录每个节点的入度,即 indegree[i] 记录节点 i 的入度。 3、对 BFS 队列进行初始化,将入度为 0 的节点首先装入队列。 4、开始执行 BFS 循环,不断弹出队列中的节点,同时减少相邻节点的入度,然后将入度变为 0 的节点加入队列。 5、如果最终所有节点都被遍历过(count 等于节点数),则说明不存在环,反之则说明存在环。
拓扑排序
直观地说就是,让你把一幅图「拉平」,而且这个「拉平」的图里面,所有箭头方向都是一致的
对于任何无环的AOV网,其顶点均可排成拓扑序列,其拓扑序列未必唯一 
进行拓扑排序之前,先要确保图中没有环。是DAG(有向无环图)
基于 DFS 的拓扑排序
图的「逆后序dfs遍历」顺序,就是拓扑排序的结果。
当左右子树的节点都被装到结果列表里面了,根节点才会被装进去。 后序遍历的这一特点很重要,之所以拓扑排序的基础是后序遍历,是因为一个任务必须等到它依赖的所有任务都完成之后才能开始开始执行。
    void traverse(vector<int>* graph, int s) {


        if (onPath[s]) {


            // 发现环
            hasCycle = true;
        }
        if (visited[s] || hasCycle) {


            return;
        }
        // 前序遍历位置
        onPath[s] = true;
        visited[s] = true;
        for (int t : graph[s]) {


            traverse(graph, t);
        }
        // 后序遍历位置
        postorder.push_back(s);
        onPath[s] = false;
    }
BFS:Kahn 算法(基于 BFS 的拓扑排序)
基于BFS 版本的环检测算法,那么就很容易得到 BFS 版本的拓扑排序算法,因为弹出节点的顺序即为拓扑排序结果。
什么样的 DAG 具有唯一的拓扑序列? - 在 Kahn 算法的每一步中,队列的大小始终为 1。 - 这意味着任意时刻,只有一个节点的入度为 0,顺序是完全确定的
时间复杂度为O(n+e)
图的关键路径
概念
AOE网(边活动网)是一种用顶点表示事件(相当于中介状态)、有向边表示活动、边权值表示活动耗时的有向无环图/DAG。
关键路径是AOE网中具有最大路径长度的路径,决定整个工程的最短完成时间。而把关键路径上的活动称为关键活动 ,即e==l的活动 普通活动是可以拖延的
普通活动 a _ i ( u r i g h t a r r o w v ) a\_i (u \\rightarrow v) a_i(urightarrowv) 的时间余量 d d d 计算公式为:
d = v l ( v ) − v e ( u ) − t e x t d u r a t i o n ( a _ i ) d = vl(v) - ve(u) - \\text{duration}(a\_i) d=vl(v)−ve(u)−textduration(a_i)
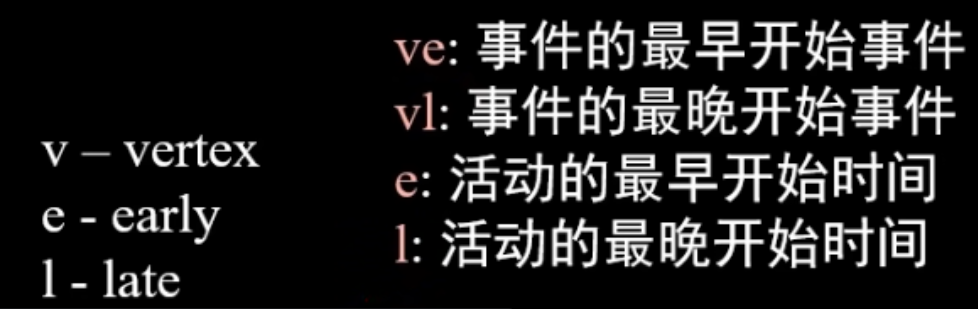
关键路径求解算法:
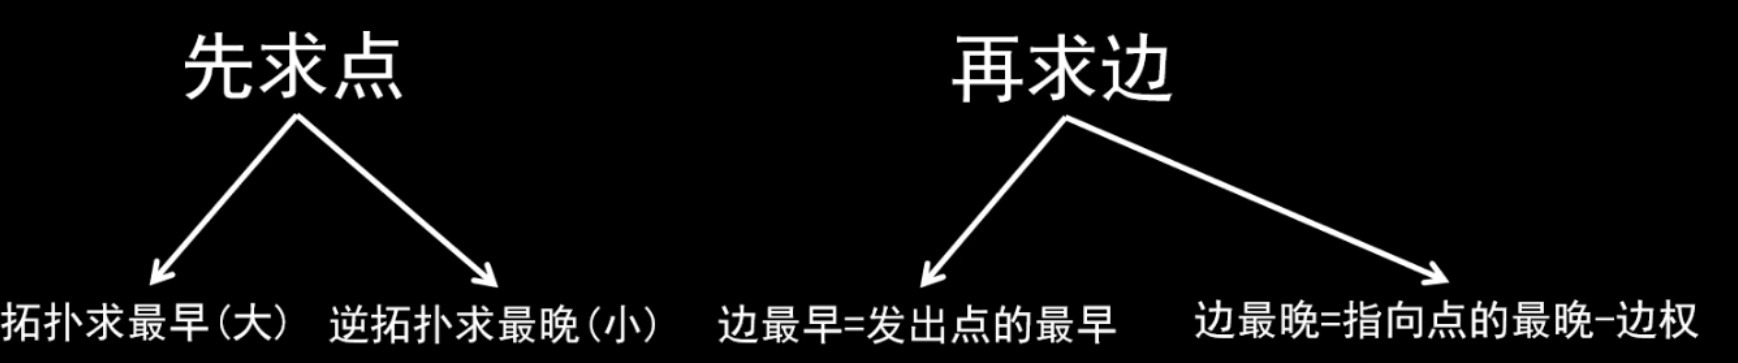
ve是到达该事件最耗时的路径(需要保证前置活动都完成) vl 越小越好 因为要保证后面的活动全部都可以做完
- 正向拓扑排序求 KaTeX parse error: Undefined control sequence: \[ at position 3: ve\̲[̲\]
- 逆向拓扑排序求 KaTeX parse error: Undefined control sequence: \[ at position 3: vl\̲[̲\]
- e是发出点的ve l是指向点的vl-w
- 遍历边判定 e = = l e == l e==l
时间复杂度: O ( V + E ) O(V + E) O(V+E)
排序
稳定性: 排序后“相同元素”的相对位置不改变
平方阶复杂度:
选择排序
关键词比较次数与元素的初始排列无关 结果近似是 n^2 / 2,所以这个排序算法的时间复杂度用 Big O 表示法就是 O(n2)
冒泡排序
为什么冒泡有稳定性:冒泡算法是对 选择排序 的一种优化,通过交换 nums[sortedIndex] 右侧的逆序对完成排序。因为是两个一对交换且相同的元素不交换,所以不破坏“相同元素”的相对位置
for(int i=0;i<n;i++){


	for(int j=0;j<n-1-i;j++){


		if(a[j]>a[j+1]) swap(a[j],a[k+1]);
	}
}
➢从左往右扫描数组,如果遇到反序对(两个相邻的元素,且 前面的元素比后面大),则交换这两个元素。 ➢扫描一趟之后,则最大元素被交换到最右边。如果把数组立 起来,最大元素就像气泡一样,浮到上面。此过程称为一趟 冒泡。
插入排序
好像整理手牌一样 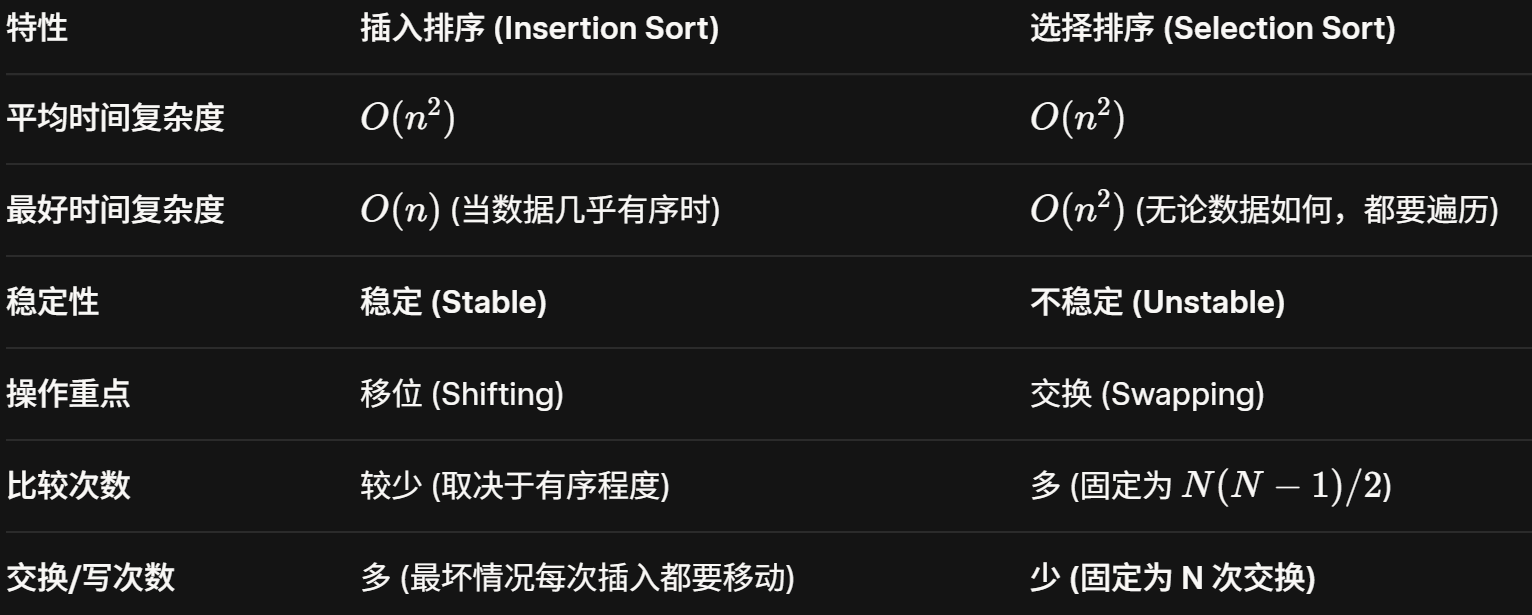
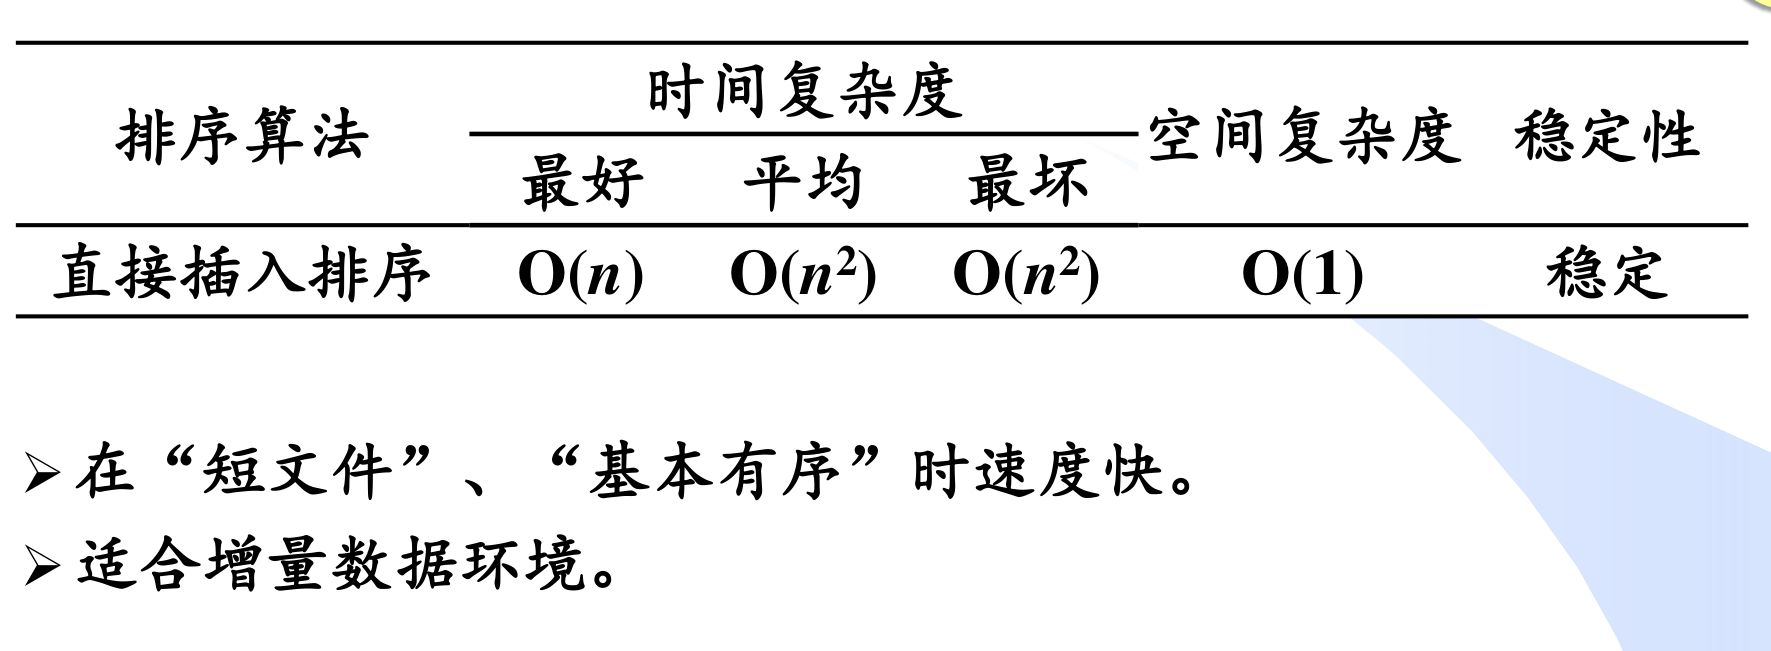
Shell排序 —— 突破 O(N^2)
AKA 缩小增量排序 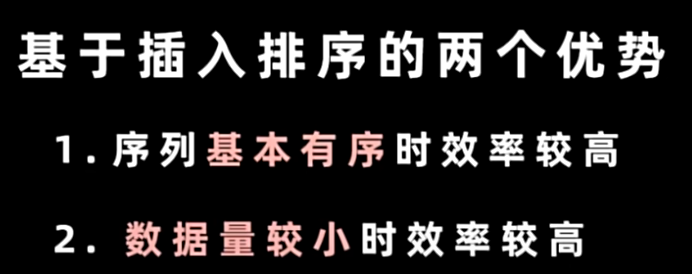
这个比较容易理解吧,当 h 大于 1 时进行的排序操作,就可能打乱相同元素的相对位置了。
堆排序
快速排序
快速排序就是是先将一个元素排好序,然后再将剩下的元素排好序
定一个基准 (Pivot),把比它小的扔左边,比它大的扔右边,然后对左右两边继续递归这样做
快速排序的过程是一个构造二叉搜索树的过程
// 使得 nums[lo..p-1] <= nums[p] < nums[p+1..hi]
int p = partition(nums, lo, hi);
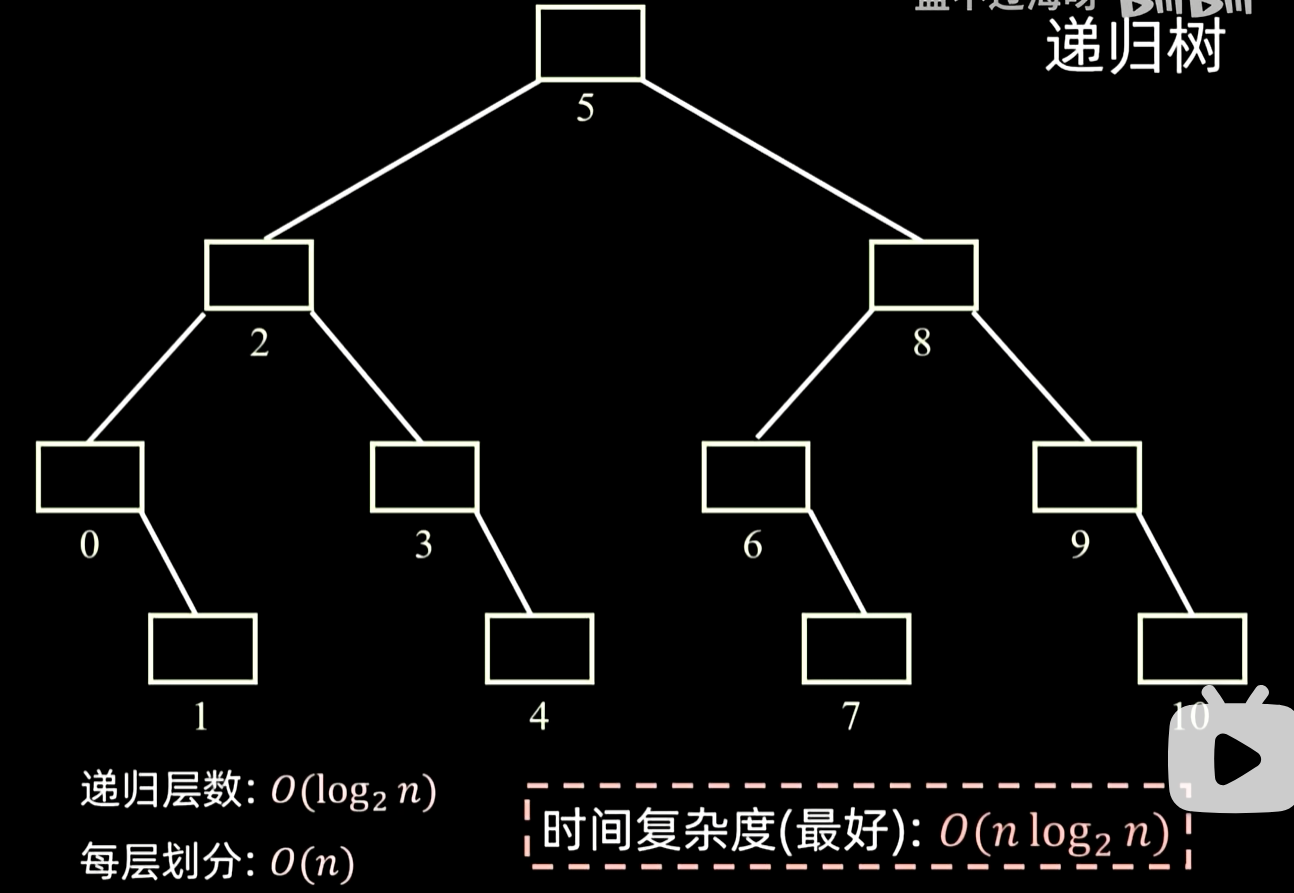
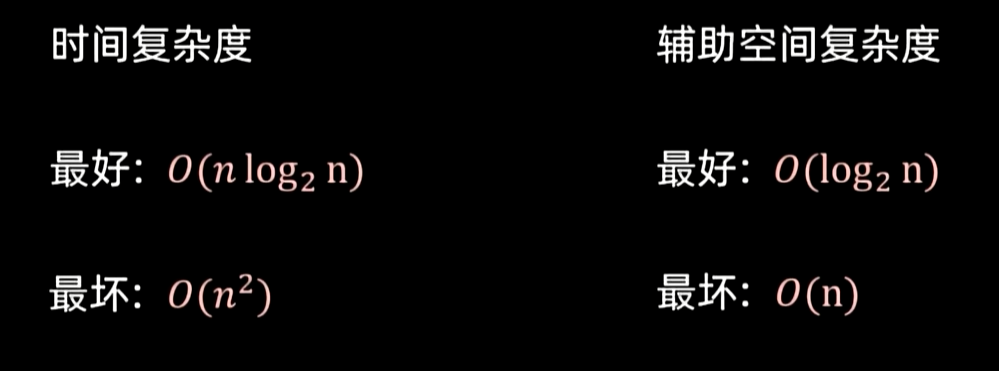
优化: (1)处理小数据时结合插入排序 当待排序元素很少时,为极小的子数组产生许多的递归调用,得不偿失,此时快速排序反而没有插入排序快 (2)随机选取基准元素 ➢快速排序达最坏情况的主要原因:数组有序,每次选的基准元素(第1个元素)恰好是当前子数组的最小元素
int Partition(int R[], int m, int n){

       //对子数组Rm…Rn分划
	int K=R[m], L=m+1, G=n; //Rm为基准元素
	while(L<=G) {


		while(L<=G && R[L]<=K) L++; //从左向右找第一个>K的元素
		while(R[G]>K) G--; //从右向左找第一个<=K的元素
		//G向左扫描时,即使右边所有的数都比 $K$ 大, $G$ 最终也一定会遇到 `R[m]` 故不需要判断越界
		if(L<G) {

      swap(R[L],R[G]); L++; G--;}
	}
	swap(R[m],R[G]);
	return G;
}
快速选择算法
快速排序算法还有一些有趣的变体,比如快速选择算法(Quick Select),主要场景是寻找第 k大的元素 或者求中位数(k=N/2)。
稳定的排序————
归并排序
归并排序的本质是分治:把序列从中间一分为二,递归排好左右两半,最后合并两个有序子序列。
先把数组从中间切分到只剩一个元素,再两两有序合并回去 可以看作为特殊的桶排序
class Merge {


private:
    // 用于辅助合并有序数组
    static vector<int> temp;

public:
    static void sort(vector<int>& nums) {


        // 先给辅助数组开辟内存空间
        temp.resize(nums.size());
        // 排序整个数组(原地修改)
        sort(nums, 0, nums.size() - 1);
    }

private:
    // 定义:将子数组 nums[lo..hi] 进行排序
    static void sort(vector<int>& nums, int lo, int hi) {


        if (lo == hi) {


            return;
        }
        // 这样写是为了防止溢出,效果等同于 (hi + lo) / 2
        int mid = lo + (hi - lo) / 2;

        sort(nums, lo, mid);
        sort(nums, mid + 1, hi);
        // 后续位置将两部分有序数组合并成一个有序数组
        merge(nums, lo, mid, hi);
    }

    // 将 nums[lo..mid] 和 nums[mid+1..hi] 这两个有序数组合并成一个有序数组
    static void merge(vector<int>& nums, int lo, int mid, int hi) {


        // 先把 nums[lo..hi] 复制到辅助数组中
        // 以便合并后的结果能够直接存入 nums
        for (int i = lo; i <= hi; i++) {


            temp[i] = nums[i];
        }

        // 数组双指针技巧,合并两个有序数组
        int i = lo, j = mid + 1;
        for (int p = lo; p <= hi; p++) {


            if (i == mid + 1) {


                // 左半边数组已全部被合并
                nums[p] = temp[j++];
            } else if (j == hi + 1) {


                // 右半边数组已全部被合并
                nums[p] = temp[i++];
            } else if (temp[i] > temp[j]) {


                nums[p] = temp[j++];
            } else {


                nums[p] = temp[i++];
            }
        }
    }
};

// 在类外部定义并初始化静态变量 temp
vector<int> Merge::temp;
外排序
分布排序:
计数排序 一句话概括: 利用数组下标代表数值,统计每个数字出现的频率,最后按顺序把数字“倒”出来。 “空间换时间” 核心限制: 只能排整数,且最大值与最小值的差(范围)不能太大,否则内存爆炸。
桶排序 分为 k k k 组(桶):根据数据范围(映射函数)将数据分发到不同的桶里 对每组单独排序 合并到一起:直接按桶的顺序拼接即可
基数排序,一种非比较排序 按位处理
查找/检索
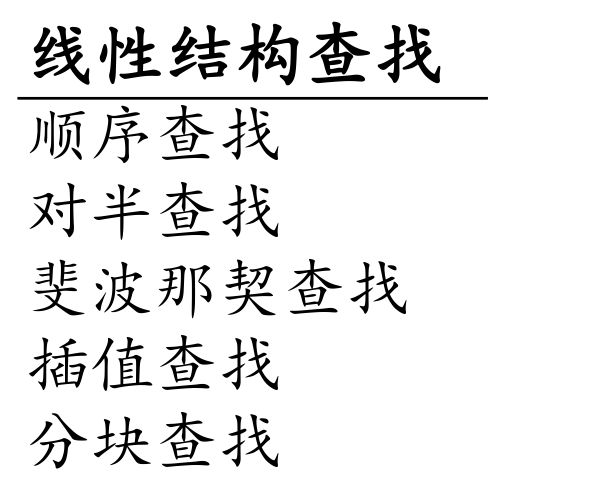
线性查找
有序表的二分查找
对半插入排序 ➢插入Ri时,基于对半查找确定插入的位置,可将每次插入的关键词比较次数降为O(logn) 。 ➢由于元素移动次数仍为O(n),故排序算法总时间复杂度仍为O(n2),但常数更低
对半查找二叉判定树
散列表
散列函数
冲突处理
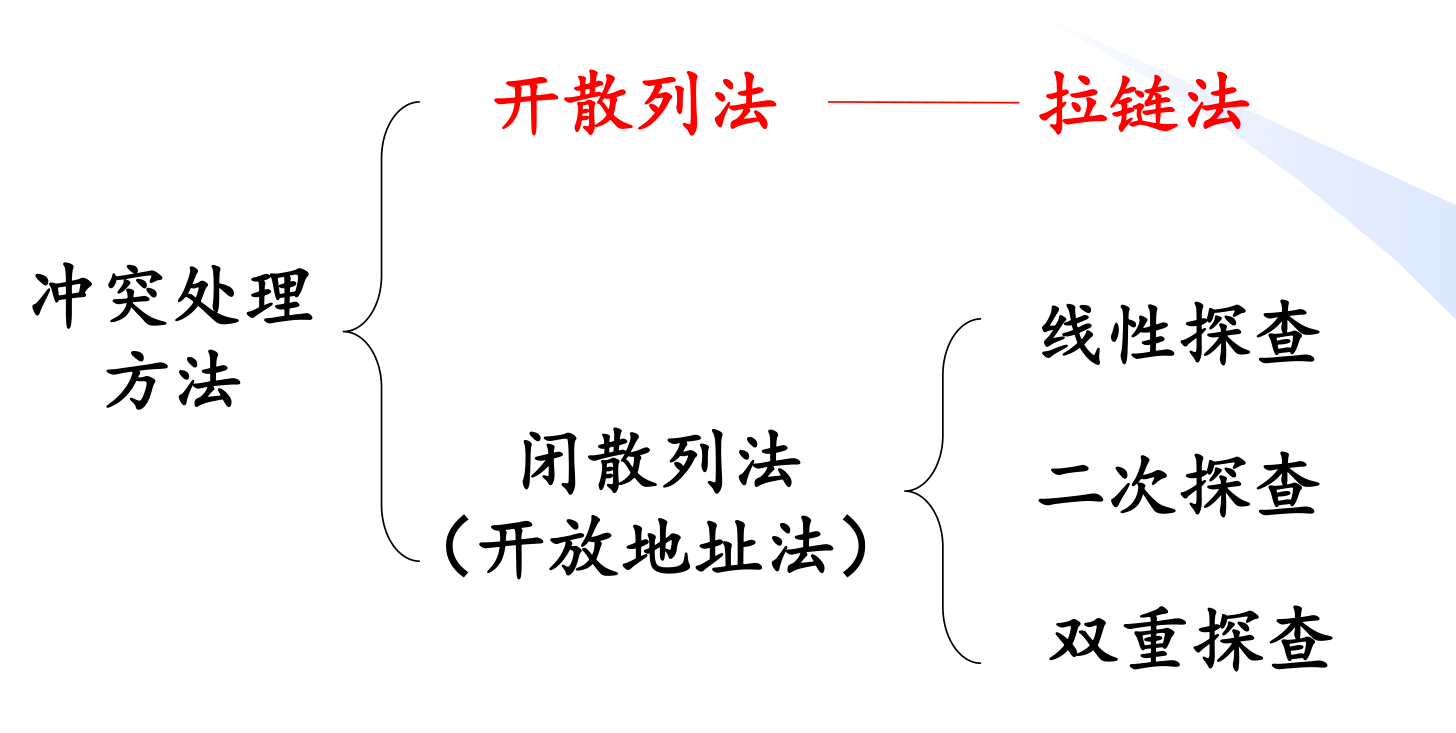
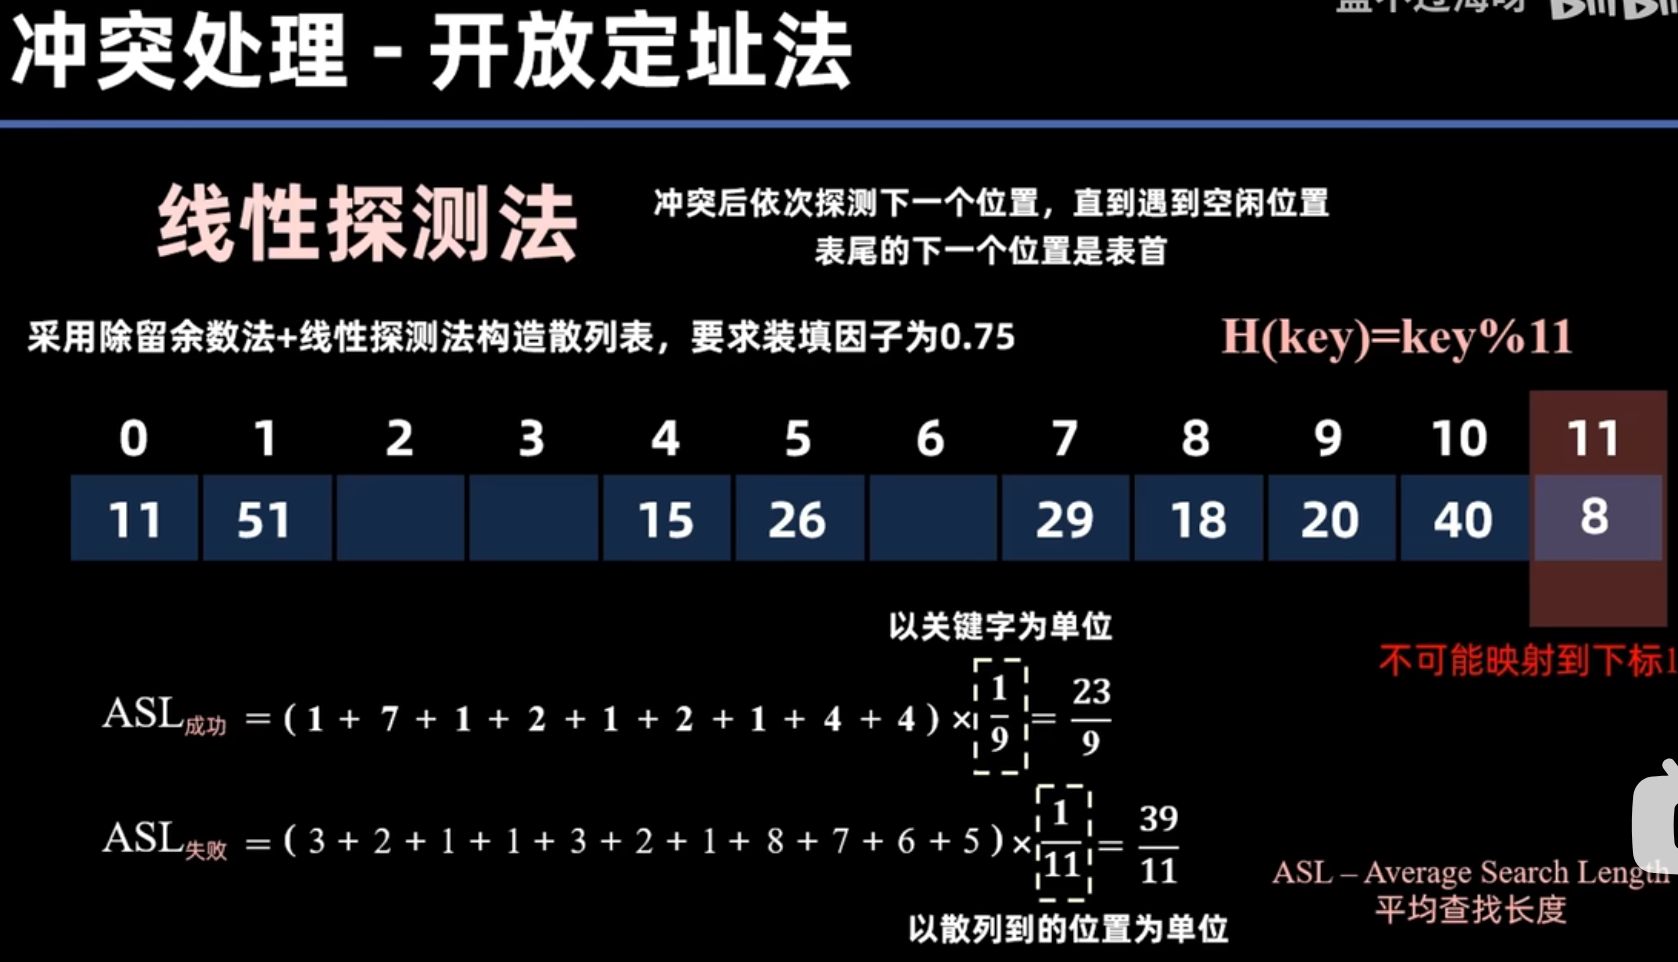
散列表的删除
- 懒惰删除
- 实时删除——适用于线性探测法 删除T[j]:将位置j清空,然后考察位置j+1到下一个空位前的每一个位置i,看将位置j清空后,是否阻碍查找T[i]的探查路径,若是则将T[i]前移至空位。
原文地址:数据结构
本文持续更新,最新内容及相关资料请访问原文。