✨作者主页:IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
精彩专栏推荐⬇⬇⬇
Java项目
Python项目
安卓项目
微信小程序项目
一、前言
系统介绍
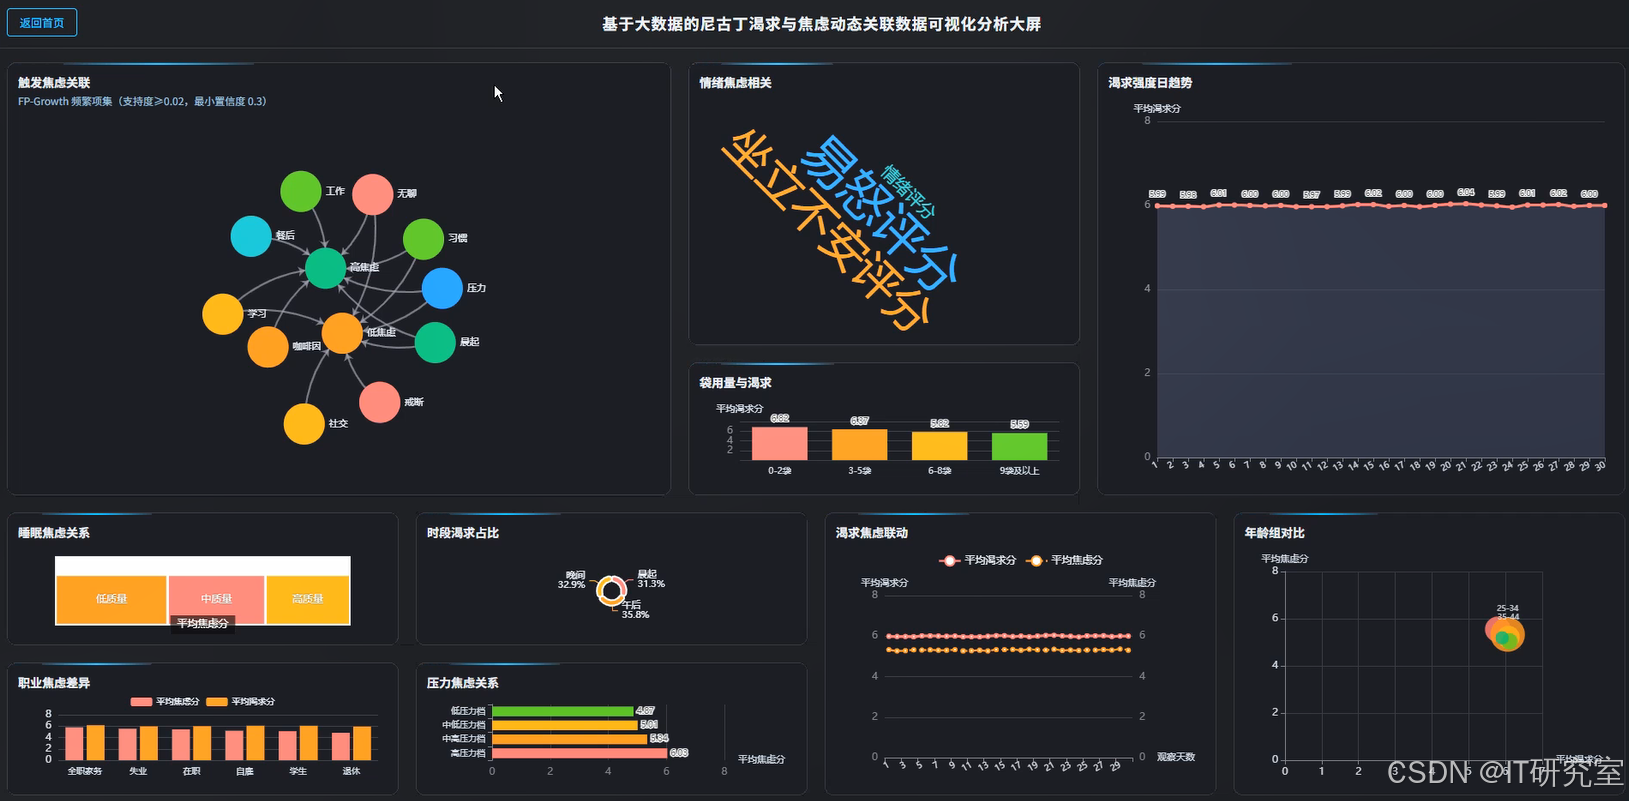
本系统名为《基于大数据的尼古丁渴求与焦虑动态关联数据可视化分析》,面向尼古丁渴求与焦虑之间动态关联关系的挖掘与展示需求,采用Hadoop+HDFS进行原始数据的分布式存储,借助Spark与Spark SQL完成数据清洗、特征提取与关联计算,并以Python+Django作为后端服务框架,前端基于Vue+ElementUI+Echarts构建可视化界面,数据持久化采用MySQL。系统围绕尼古丁动态数据管理、渴求动态分析、焦虑关联分析、综合大屏可视化等核心业务展开,支持对尼古丁渴求强度与焦虑水平在时间维度上的动态变化进行统计与关联呈现,并通过综合大屏将关键指标、趋势曲线与关联结果集中展示,为相关数据的整理、分析与直观呈现提供一套完整可行的技术实现方案。
选题背景
近年来,尼古丁依赖与情绪状态之间的关系受到越来越多关注,尼古丁渴求往往并非孤立出现,而是与焦虑等情绪波动在时间上呈现出一定的同步或滞后特征。这类数据具有记录频次高、维度多、时间跨度长的特点,传统的手工统计或单机处理方式在数据量上升后容易出现效率下降、关联关系难以量化的问题。与此同时,大数据处理技术在高校毕业设计阶段已具备较为成熟的应用条件,Hadoop与Spark能够为中等规模数据的存储与并行计算提供支撑,Spark SQL也便于对时间序列数据进行分组统计与关联分析。在这样的背景下,如何把分散的尼古丁渴求记录与焦虑评估数据整合起来,借助大数据框架完成动态关联分析,并通过可视化手段把结果清晰地呈现出来,成为一个具有现实操作价值的课题方向,本系统正是围绕这一思路展开设计与实现。
选题意义
从实际应用角度看,本系统把尼古丁渴求数据与焦虑评估数据放在同一套分析流程中处理,能够较为直观地呈现两者在时间维度上的变化趋势和关联特征,帮助使用者更快地理解数据背后的大致规律,减少人工逐条比对的工作量。从技术实践角度看,课题将Hadoop、Spark与Django、Vue等技术串联起来,覆盖数据存储、并行计算、接口服务与可视化展示等环节,对计算机专业学生而言是一次较为完整的工程训练,有助于加深对大数据处理流程的理解。从学习与参考角度看,系统所采用的动态关联分析与大屏展示思路,可为同类健康行为数据的整理与呈现提供一种可借鉴的实现方式。需要说明的是,本系统定位为毕业设计层面的实践作品,分析深度与数据规模均有限,更多是提供一个可运行、可扩展的技术原型,其结论不具备专业医学参考价值,主要意义在于把课堂所学技术落到实处,并为后续更深入的研究留出继续完善的空间。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
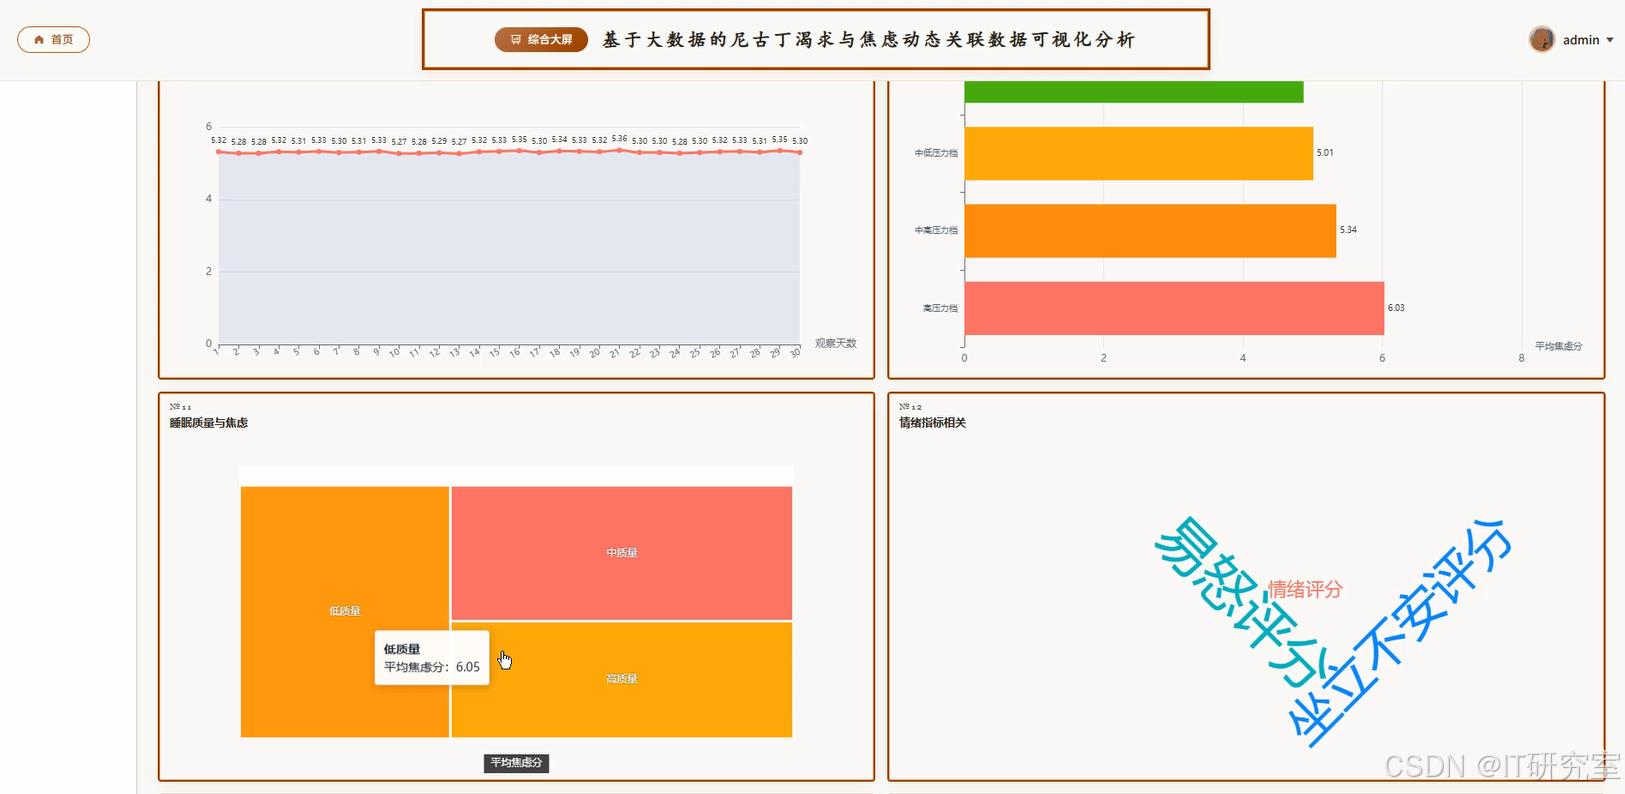
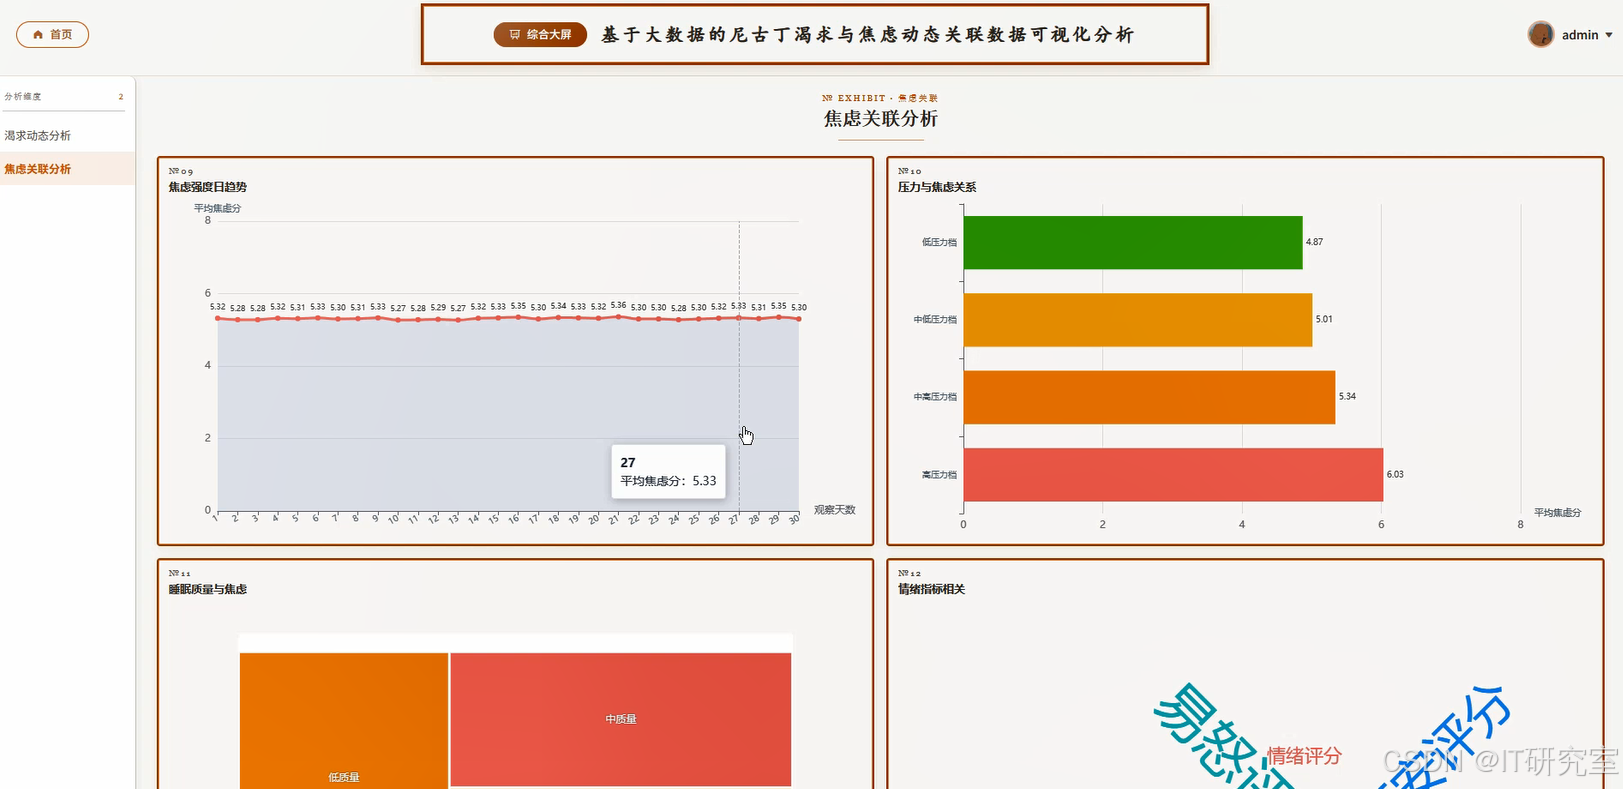
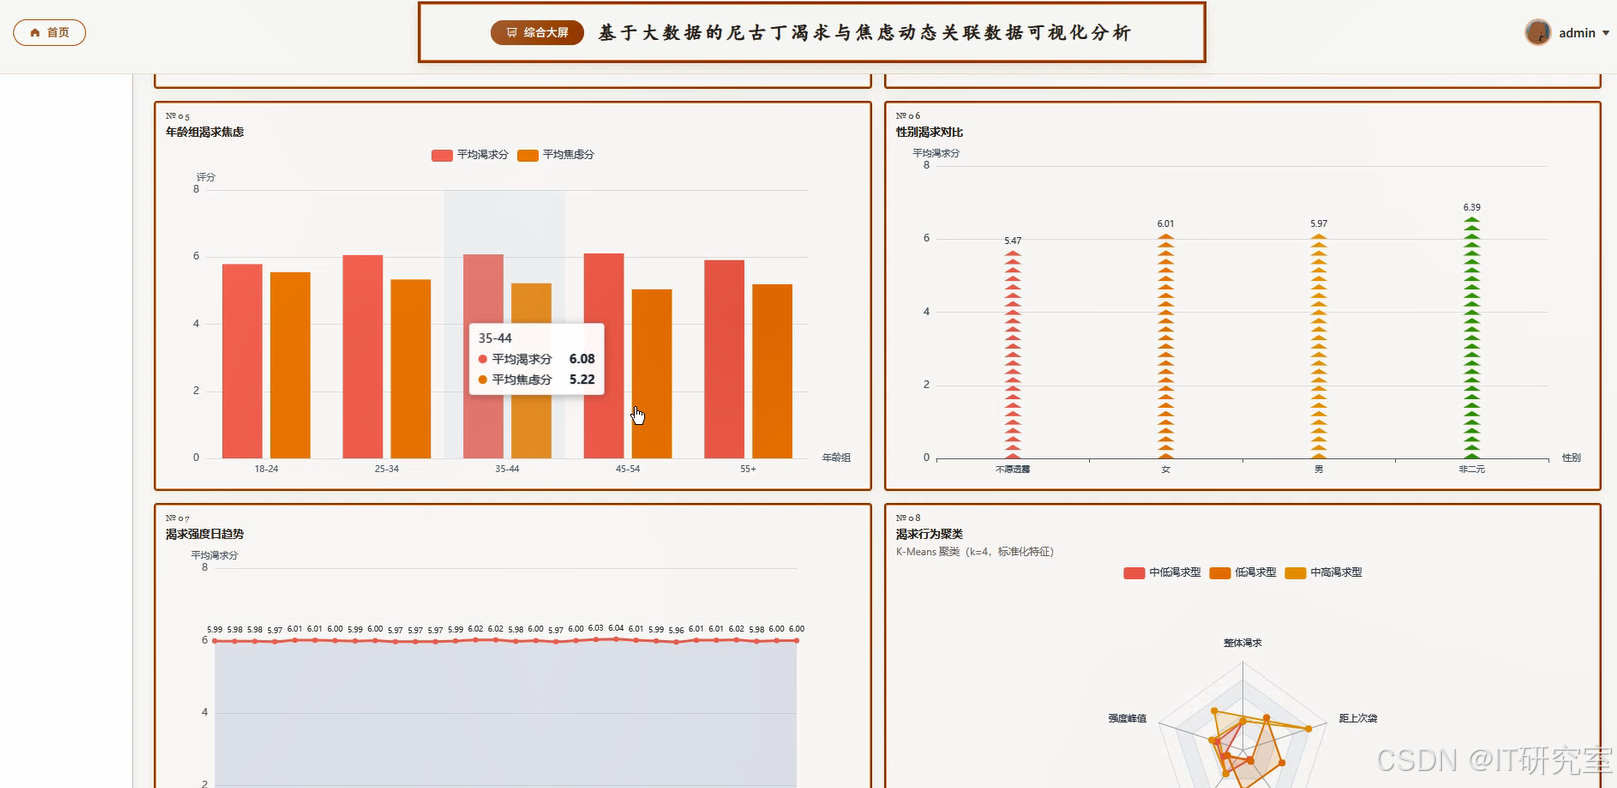
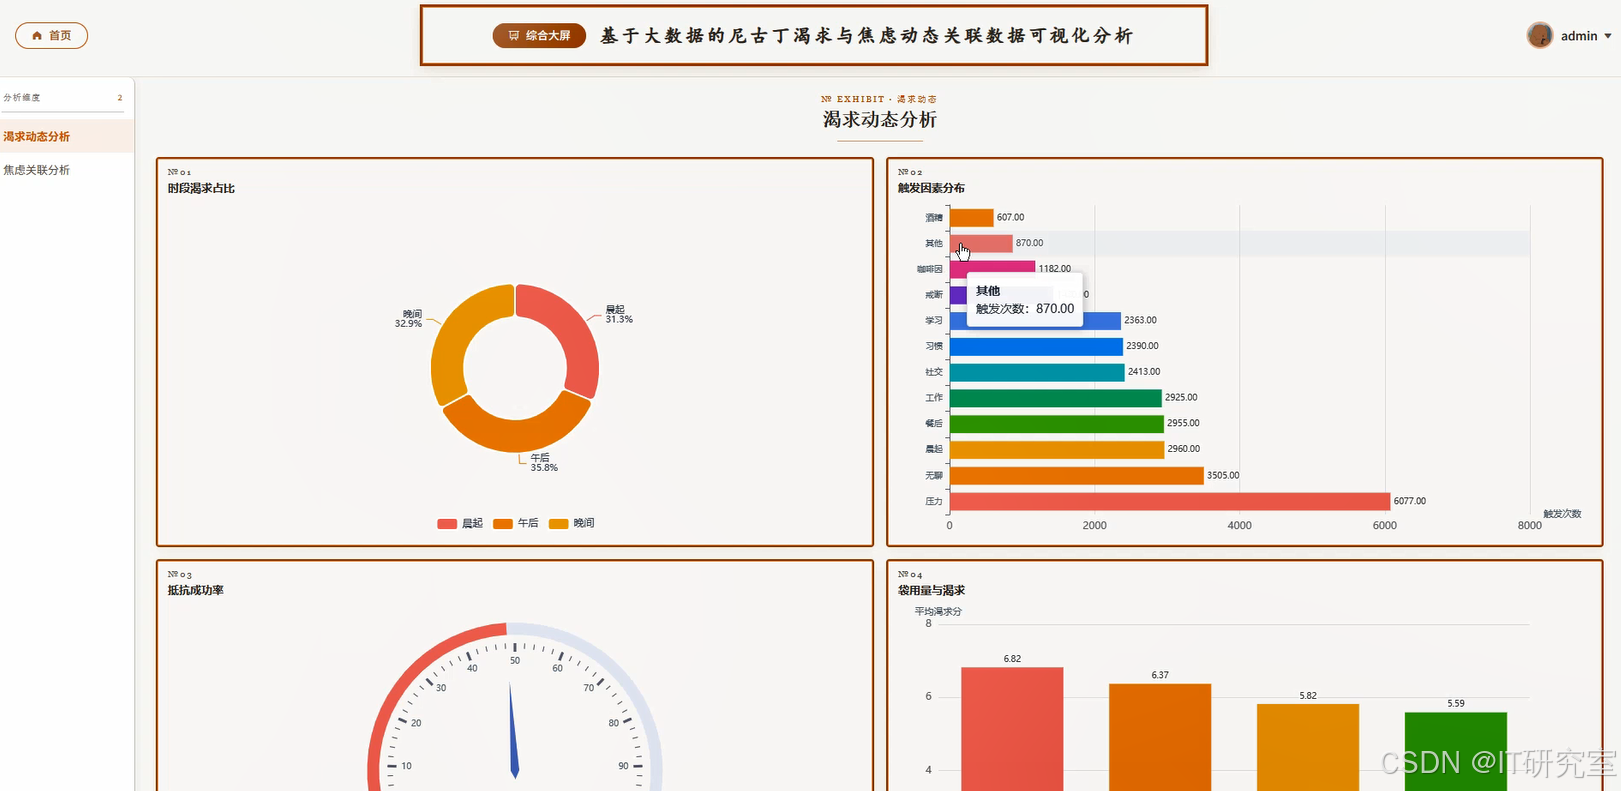
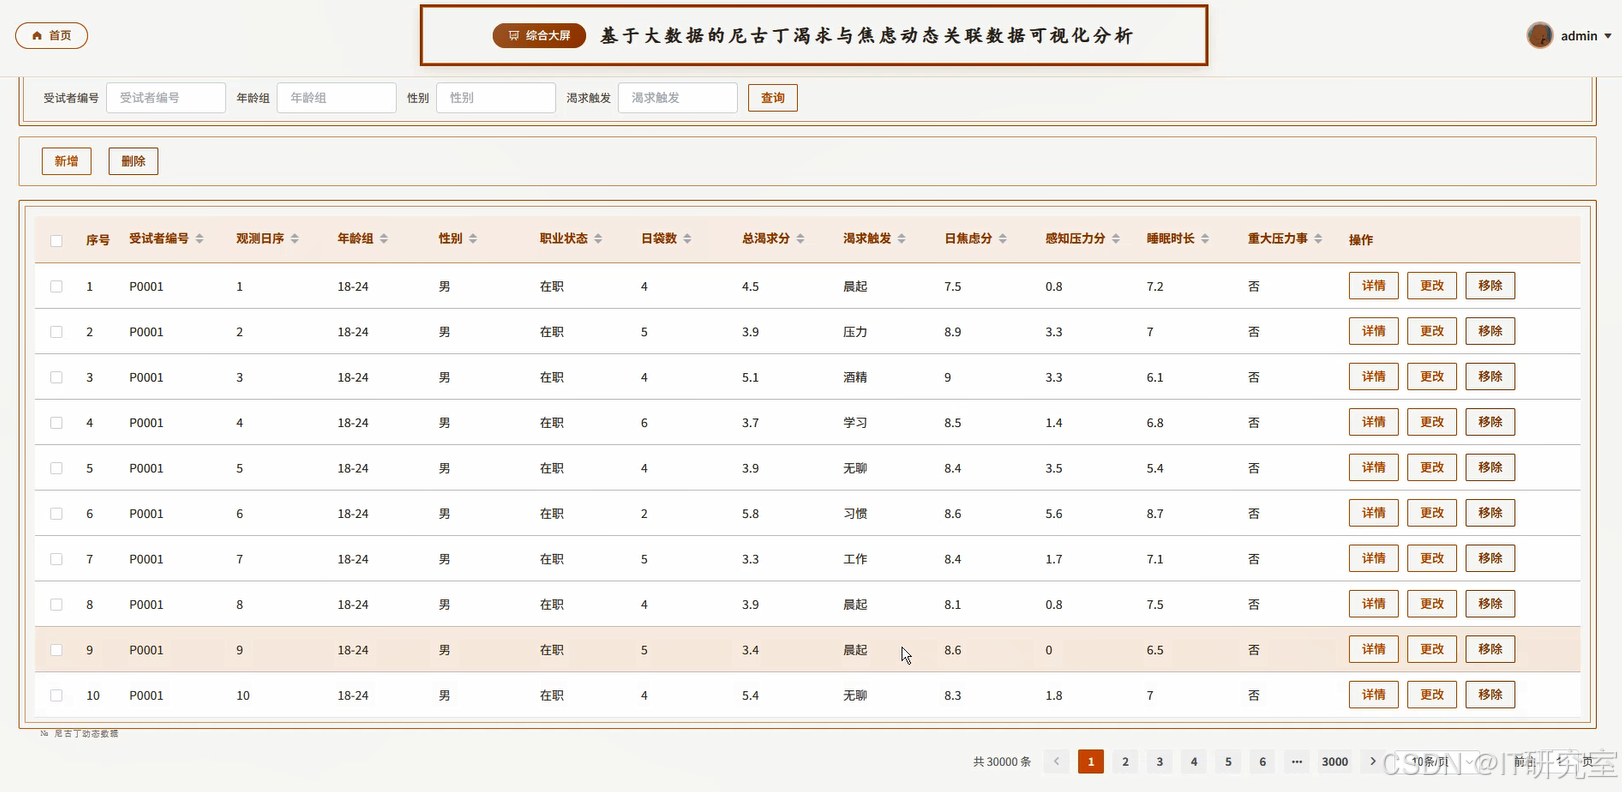
- 基于大数据的尼古丁渴求与焦虑动态关联数据可视化分析界面展示:
四、代码参考
- 项目实战代码参考:
from pyspark.sql import SparkSession
from pyspark.sql import functions as F
from django.http import JsonResponse
from django.views.decorators.csrf import csrf_exempt
from .models import CravingRecord, AnxietyRecord, AssociationResult
import json

spark = SparkSession.builder.appName("NicotineCravingAnxietyAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()

@csrf_exempt
def craving_dynamic_analysis(request):
    if request.method != "POST":
        return JsonResponse({"code": 400, "msg": "请求方式错误"})
    params = json.loads(request.body)
    user_id = params.get("userId")
    start_date = params.get("startDate")
    end_date = params.get("endDate")
    if not user_id or not start_date or not end_date:
        return JsonResponse({"code": 401, "msg": "参数缺失"})
    records = CravingRecord.objects.filter(user_id=user_id, record_date__range=(start_date, end_date)).values("record_date", "craving_level", "smoke_count")
    if not records:
        return JsonResponse({"code": 402, "msg": "暂无渴求数据"})
    df = spark.createDataFrame(list(records))
    df = df.withColumn("record_date", F.to_date(F.col("record_date")))
    daily_df = df.groupBy("record_date").agg(F.avg("craving_level").alias("avg_craving"), F.sum("smoke_count").alias("total_smoke"), F.count("*").alias("record_times"))
    daily_df = daily_df.withColumn("craving_trend", F.when(F.col("avg_craving") > F.lag("avg_craving", 1).over(Window.orderBy("record_date")), "上升").when(F.col("avg_craving") < F.lag("avg_craving", 1).over(Window.orderBy("record_date")), "下降").otherwise("平稳"))
    result_list = [row.asDict() for row in daily_df.collect()]
    for item in result_list:
        item["record_date"] = str(item["record_date"])
    peak_row = daily_df.orderBy(F.desc("avg_craving")).first()
    summary = {"avgCraving": round(daily_df.agg(F.avg("avg_craving")).first()[0], 2), "peakDate": str(peak_row["record_date"]), "peakValue": round(peak_row["avg_craving"], 2), "totalDays": daily_df.count()}
    return JsonResponse({"code": 200, "data": result_list, "summary": summary})

@csrf_exempt
def anxiety_association_analysis(request):
    if request.method != "POST":
        return JsonResponse({"code": 400, "msg": "请求方式错误"})
    params = json.loads(request.body)
    user_id = params.get("userId")
    start_date = params.get("startDate")
    end_date = params.get("endDate")
    if not user_id or not start_date or not end_date:
        return JsonResponse({"code": 401, "msg": "参数缺失"})
    craving_records = CravingRecord.objects.filter(user_id=user_id, record_date__range=(start_date, end_date)).values("record_date", "craving_level")
    anxiety_records = AnxietyRecord.objects.filter(user_id=user_id, record_date__range=(start_date, end_date)).values("record_date", "anxiety_score")
    if not craving_records or not anxiety_records:
        return JsonResponse({"code": 402, "msg": "关联数据不足"})
    craving_df = spark.createDataFrame(list(craving_records)).withColumn("record_date", F.to_date(F.col("record_date")))
    anxiety_df = spark.createDataFrame(list(anxiety_records)).withColumn("record_date", F.to_date(F.col("record_date")))
    craving_daily = craving_df.groupBy("record_date").agg(F.avg("craving_level").alias("avg_craving"))
    anxiety_daily = anxiety_df.groupBy("record_date").agg(F.avg("anxiety_score").alias("avg_anxiety"))
    joined_df = craving_daily.join(anxiety_daily, on="record_date", how="inner")
    if joined_df.count() < 2:
        return JsonResponse({"code": 403, "msg": "有效关联天数不足"})
    corr_value = joined_df.stat.corr("avg_craving", "avg_anxiety")
    joined_df = joined_df.withColumn("association_level", F.when(F.abs(F.col("avg_craving") - F.col("avg_anxiety")) <= 1, "强关联").when(F.abs(F.col("avg_craving") - F.col("avg_anxiety")) <= 3, "中等关联").otherwise("弱关联"))
    association_list = [row.asDict() for row in joined_df.collect()]
    for item in association_list:
        item["record_date"] = str(item["record_date"])
    AssociationResult.objects.filter(user_id=user_id, record_date__range=(start_date, end_date)).delete()
    for item in association_list:
        AssociationResult.objects.create(user_id=user_id, record_date=item["record_date"], avg_craving=item["avg_craving"], avg_anxiety=item["avg_anxiety"], association_level=item["association_level"])
    direction = "正相关" if corr_value > 0 else "负相关"
    strength = "较强" if abs(corr_value) >= 0.6 else ("中等" if abs(corr_value) >= 0.3 else "较弱")
    return JsonResponse({"code": 200, "data": association_list, "correlation": round(corr_value, 3), "direction": direction, "strength": strength})

@csrf_exempt
def comprehensive_dashboard(request):
    if request.method != "GET":
        return JsonResponse({"code": 400, "msg": "请求方式错误"})
    user_id = request.GET.get("userId")
    if not user_id:
        return JsonResponse({"code": 401, "msg": "参数缺失"})
    craving_records = CravingRecord.objects.filter(user_id=user_id).values("record_date", "craving_level", "smoke_count")
    anxiety_records = AnxietyRecord.objects.filter(user_id=user_id).values("record_date", "anxiety_score")
    if not craving_records and not anxiety_records:
        return JsonResponse({"code": 402, "msg": "暂无大屏数据"})
    craving_df = spark.createDataFrame(list(craving_records)).withColumn("record_date", F.to_date(F.col("record_date")))
    anxiety_df = spark.createDataFrame(list(anxiety_records)).withColumn("record_date", F.to_date(F.col("record_date")))
    craving_stat = craving_df.groupBy("record_date").agg(F.avg("craving_level").alias("avg_craving"), F.sum("smoke_count").alias("total_smoke"))
    anxiety_stat = anxiety_df.groupBy("record_date").agg(F.avg("anxiety_score").alias("avg_anxiety"))
    merged_df = craving_stat.join(anxiety_stat, on="record_date", how="full_outer").orderBy("record_date")
    trend_list = [{"date": str(row["record_date"]), "craving": round(row["avg_craving"], 2) if row["avg_craving"] else 0, "anxiety": round(row["avg_anxiety"], 2) if row["avg_anxiety"] else 0, "smoke": int(row["total_smoke"]) if row["total_smoke"] else 0} for row in merged_df.collect()]
    total_smoke = craving_df.agg(F.sum("smoke_count")).first()[0] or 0
    avg_craving_all = craving_df.agg(F.avg("craving_level")).first()[0] or 0
    avg_anxiety_all = anxiety_df.agg(F.avg("anxiety_score")).first()[0] or 0
    high_anxiety_days = anxiety_df.filter(F.col("anxiety_score") >= 6).count()
    high_craving_days = craving_df.filter(F.col("craving_level") >= 6).count()
    indicator = {"totalSmoke": int(total_smoke), "avgCraving": round(avg_craving_all, 2), "avgAnxiety": round(avg_anxiety_all, 2), "highAnxietyDays": high_anxiety_days, "highCravingDays": high_craving_days}
    top_days = merged_df.orderBy(F.desc("avg_craving")).limit(5).collect()
    top_list = [{"date": str(row["record_date"]), "craving": round(row["avg_craving"], 2) if row["avg_craving"] else 0, "anxiety": round(row["avg_anxiety"], 2) if row["avg_anxiety"] else 0} for row in top_days]
    return JsonResponse({"code": 200, "trend": trend_list, "indicator": indicator, "topDays": top_list})
五、系统视频
基于大数据的尼古丁渴求与焦虑动态关联数据可视化分析项目视频:
演示视频
结语
最新大数据毕业设计选题推荐-基于大数据的尼古丁渴求与焦虑动态关联数据可视化分析-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇