📖标题:AdviSD: Learning to Advise Frontier LLMs via Targeted Multi-Turn Self-Distillation
🌐来源:arXiv, 2609.38142v1
🛎️文章简介
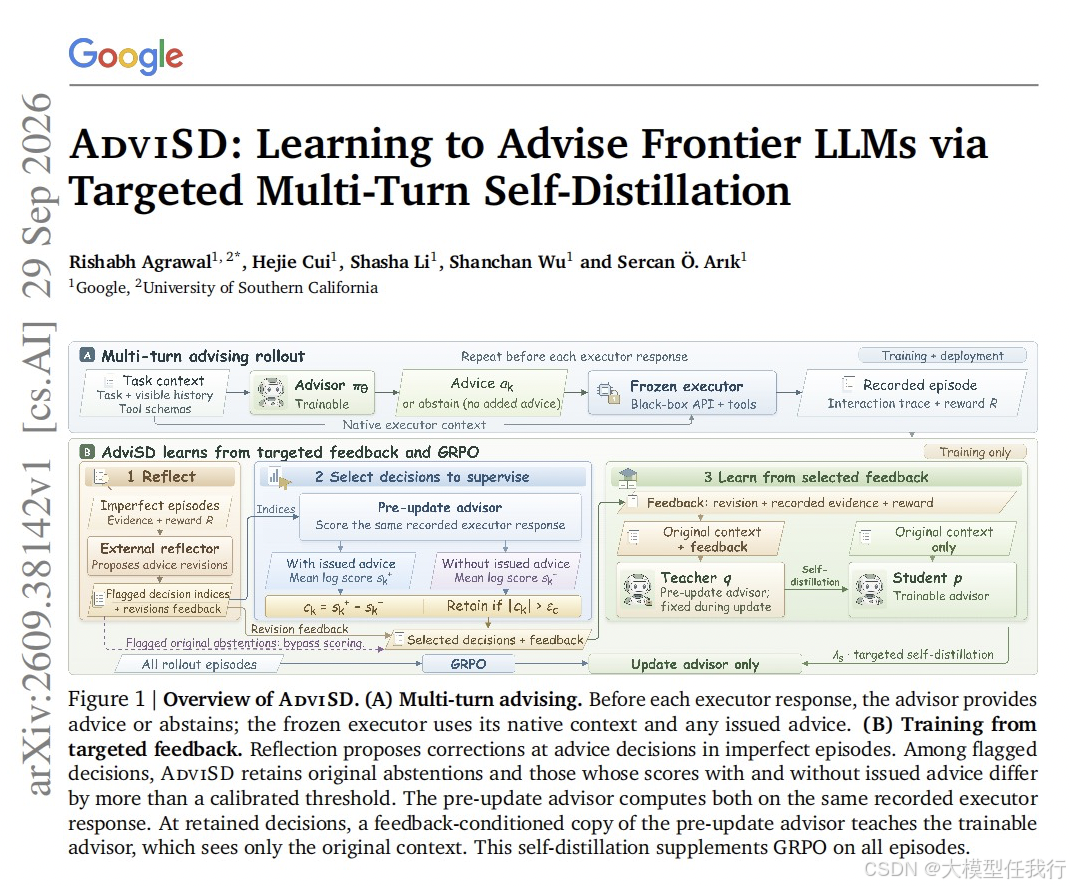
🔸研究问题:如何在不修改冻结的大语言模型权重的情况下,通过训练一个小型“顾问”模型来指导其执行复杂任务,并解决从所有反馈中学习可能带来的噪音干扰问题?
🔸主要贡献:论文提出了AdviSD方法,结合强化学习与针对性自蒸馏,通过筛选高价值反馈进行训练,显著提升了顾问模型对前沿大模型的指导效果。
📝重点思路
🔸理论分析指出,并非所有修正建议都有益。如果顾问模型从那些即使不改变建议、执行结果也相同的“不敏感”场景中学习,可能会稀释对关键“敏感”场景的学习信号,从而限制最终性能上限。
🔸设计预测性选择机制。顾问模型在训练时,对比同一执行器响应在“有建议”和“无建议”两种上下文下的得分差异。利用该差异的绝对值作为信号,仅保留那些建议对预测结果影响显著的决策点进行监督学习,无需额外的执行器 rollout。
🔸实施针对性自蒸馏。对于筛选出的关键决策点,使用一个能看到完整反馈信息的教师模型(顾问模型的副本)来指导只能看到原始上下文的学生模型(待训练的顾问),同时结合基于任务奖励的GRPO算法进行联合优化。
🔎分析总结
🔸在BFCL-v3和EnvScaler基准测试中,AdviSD相比仅使用强化学习的基线方法,准确率提升了4.2–6.4个百分点,证明了针对性选择反馈的有效性。
🔸消融实验显示,AdviSD优于随机选择相同数量反馈的控制组,也优于学习所有反馈或反向选择低差异反馈的方法,证实了基于预测差异的选择规则能捕捉更有价值的学习信号。
🔸该方法具备良好的泛化能力。未经重新训练的顾问模型在跨领域任务、不同版本的执行器甚至不同家族的大模型间迁移时,仍能保持性能优势,且优于其他