AI Agent 正在从辅助对话走向自主执行任务,模型的推理能力、工具调用和成本效率也成为新的关注重点。OpenAI 在11 月推出 GPT-6.2 Astra 和 Sol两款模型,分别面向复杂专业任务与日常工作。两款模型究竟有什么区别?本文从功能升级、性能表现和应用场景展开对比,帮你快速选对模型。
一、GPT-6.2 Astra 和 Sol 是什么?
GPT-6.2 Astra 和 GPT-6.2 Sol 是 OpenAI 在11月推出的新一代通用 AI 大语言模型,支持文本理解、图像分析、内容生成和工具调用,可用于日常问答、代码开发及 Agent 工作流。两款模型并不是简单的高低配关系,而是面向不同工作负载进行设计,分别承担专业任务处理与高效通用任务的角色。
GPT-6.2 Astra 是 GPT-6.2 系列中的旗舰推理模型,主要面向复杂度高、专业要求强的工作场景。相比常规通用模型,它更注重处理多层次问题、理解复杂指令,以及在较长任务链中保持分析和执行的一致性。适用领域包括金融研究、科学分析、复杂软件开发,以及 CAD、3D 设计等专业工作。
GPT-6.2 Sol 则是 GPT-6.2 系列中的高效通用模型,定位于日常工作和规模化任务处理。它兼顾语言理解、代码辅助与工具协作等,能够应对办公自动化、常规开发及日常Agent任务。对于希望将 AI 融入日常工作流程,并持续处理大量重复性任务的个人或团队,Sol是更适合的通用模型选择。
| 对比维度 |
GPT-6.2 Astra |
GPT-6.2 Sol |
| 模型定位 |
旗舰推理模型 |
高效通用模型 |
| 核心侧重 |
复杂推理与专业任务 |
日常任务与高效执行 |
| 文档处理 |
专业报告、复杂表格、演示文稿 |
日常文档、资料整理 |
| 编程能力 |
复杂代码修改、系统开发、3D设计 |
常规代码编写、调试与维护 |
| Agent 应用 |
长流程、多步骤专业任务 |
日常自动化与规模化任务 |
| 适用人群 |
专业开发者、研究人员、企业团队 |
普通用户、开发者及企业团队 |
二、GPT-6.2 Astra 和 Sol 有哪些核心升级?
1. 专业文档生成能力增强
GPT-6.2 Astra 强化了 PPT、Excel 和专业报告的生成能力,可以参考原始文件或模板截图,匹配页面布局、字体、配色和排版规范,减少人工调整。
例如,制作财务预测表时,可以上传历史财务报表和业务假设,让模型提取关键数据、建立预测工作簿并完成估值计算。生成后,还可以继续要求检查公式、调整表格结构或补充分析说明。
2. Agent 与计算机操作能力提升
两款模型都加强了多步骤 Agent 工作流的执行能力,能够拆解任务、调用工具,并根据执行结果调整后续步骤。例如,制作竞品调研报告时,可以按照以下流程配置 Agent:
- 任务拆解:明确竞品范围、目标网站和需要收集的数据字段,避免模型执行方向不明确。
- 工具调用:配置浏览器和文件处理工具,让 Agent 搜索网站、提取产品信息并整理价格。
- 结果检查:对比原始网页与提取结果,检查数据是否遗漏或错误,再生成最终报告。
Astra 在复杂专业任务和计算机操作方面更具优势,可用于 CAD 软件操作、工程建模等场景。不过,实际执行还取决于运行环境、工具权限和接口配置。
3. 编程与 3D 设计能力优化
GPT-6.2 Astra 提升了复杂代码修改、前端开发和 3D 场景构建能力,可以结合参考图片和文字需求,辅助生成交互式网页、游戏及三维模型。
实际开发时,可以先提供项目代码、功能需求和参考截图,让模型分析现有结构,再分阶段修改和检查结果。Sol 则更适合日常代码编写、调试和代码仓库维护。在 Cognition 的 FrontierCode 2.0 测试中,Astra 得分为 44.2%,Sol 为 43.8%,两者仅相差 0.4 个百分点。
4. Token 效率与网络安全升级
两款模型都优化了任务规划和输出效率,能够使用更少的输出 Token 完成部分复杂任务。实际调用时,可以通过以下方式减少不必要的消耗:
- 明确任务要求:提前说明目标、内容范围和输出格式,减少重复沟通。
- 拆分复杂任务:将长任务分阶段执行,避免一次性生成过多内容。
网络安全方面,两款模型强化了漏洞识别、安全代码生成和补丁修复能力,同时加强了安全限制。进行合法安全测试时,建议明确授权范围,优先用于代码审计、风险分析和漏洞修复。
三、GPT-6.2 Astra VS Sol:两款 AI 模型对比速览
1. 核心性能与技术规格对比
从 API 规格来看,GPT-6.2 Astra 和 Sol 具有相同的上下文窗口和最大输出长度,主要区别在于模型定位与调用价格。两款模型均支持函数调用、网页搜索、文件搜索和计算机操作等工具。
需要注意,如果需要通过 API 调用这些工具,应使用 Responses API,不能将模型支持工具理解为所有 API 接口都支持工具调用。
实际接入时,可以先根据任务复杂度选择模型,再通过对应的 Model ID 配置调用。模型的推理等级也可以按任务调整:常规任务使用较低等级,复杂分析再提高推理强度。
2. API 定价与 Token 成本对比
两款模型按照输入 Token、缓存输入 Token 和输出 Token 分别计费。以下为 OpenAI 公布的标准 API 价格:
| 计费项目(每百万 Token) |
Astra |
Sol |
| 输入 Token |
$8 |
$2 |
| 缓存输入 Token |
$0.40 |
$0.10 |
| 输出 Token |
$40 |
$10 |
从价格来看,Sol的标准输入和输出单价均为 Astra 的四分之一。Astra 相比 GPT-6 Astra,输入和输出价格降低了 20%,缓存输入价格降低了 60%;Sol则沿用 GPT-6.1 Sol 的标准价格。
因此Sol 在相同Token用量下成本更低,不过实际账单还会受到上下文长度、缓存命中率和工具调用费用影响。尤其是输入超过一定的Token请求,官方会采用不同的长上下文计费标准,不能直接套用短上下文价格。
3. 不同业务场景下的模型表现
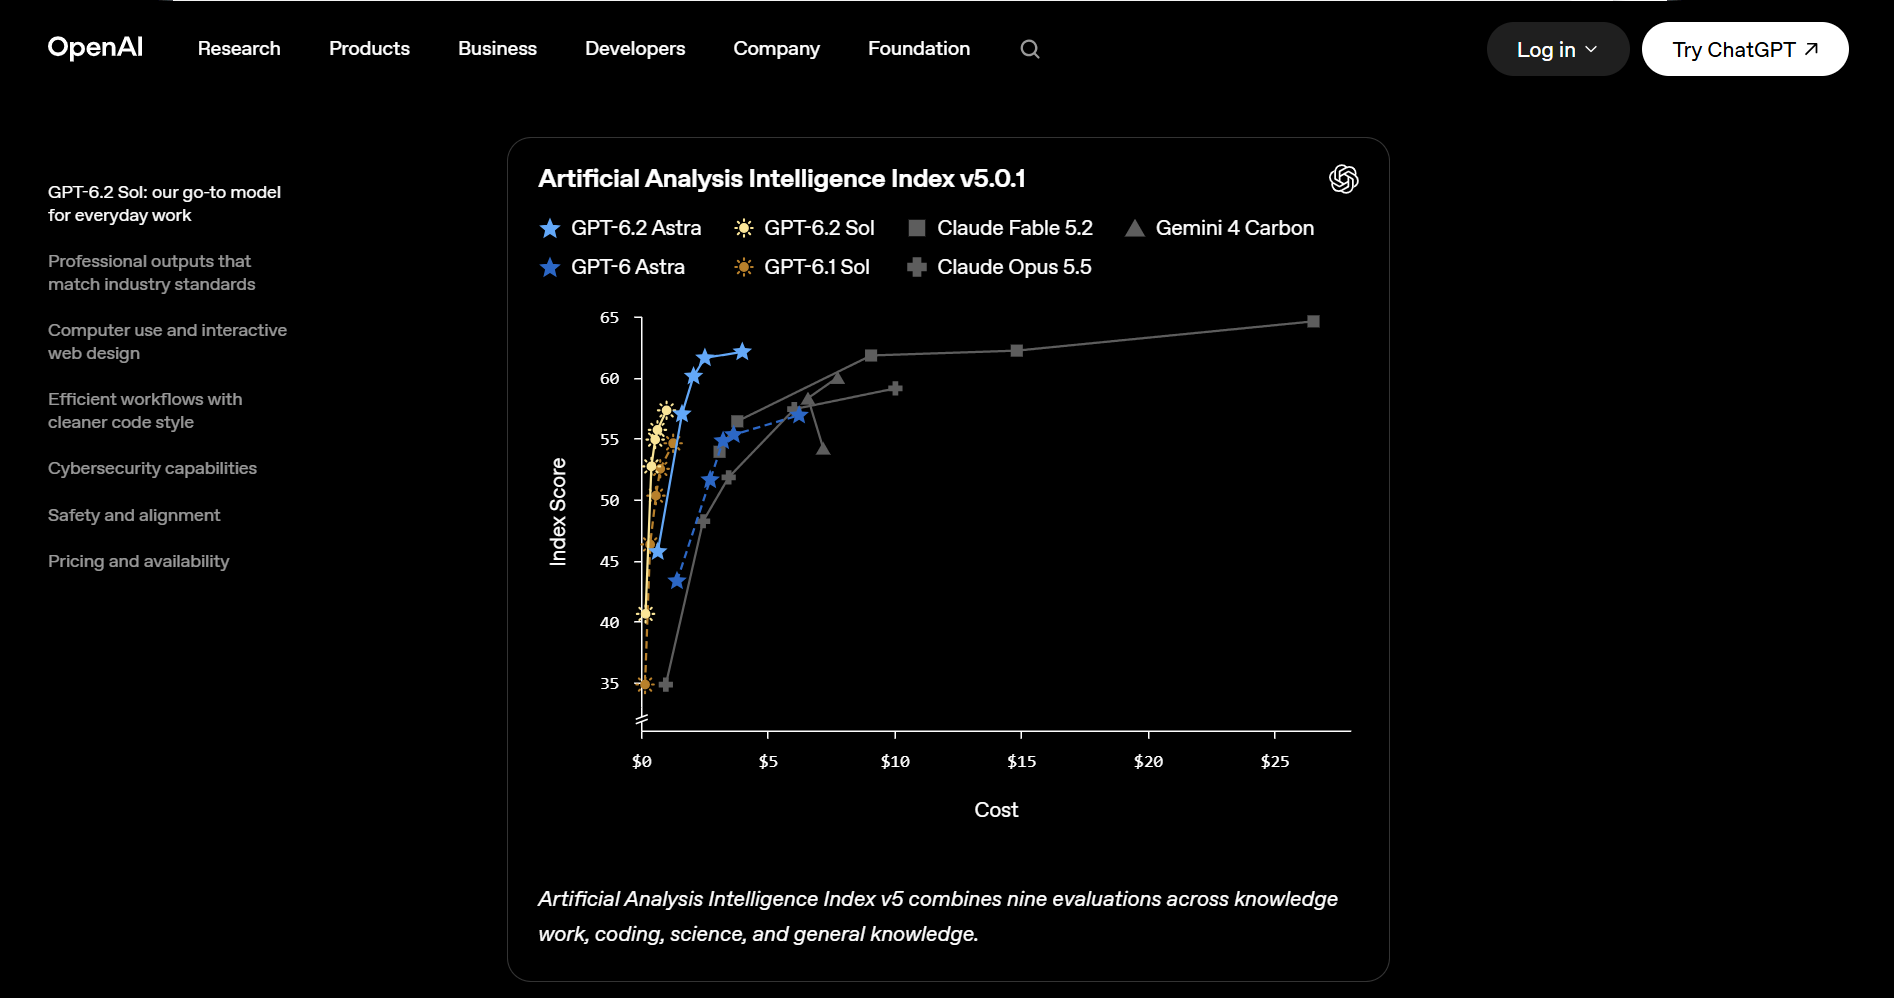
判断两款模型的性能,不能只看单项跑分,还要结合测试任务类型。OpenAI 在发布公告中公布了专业工作、科学研究、编程和日常任务等多个评测结果。
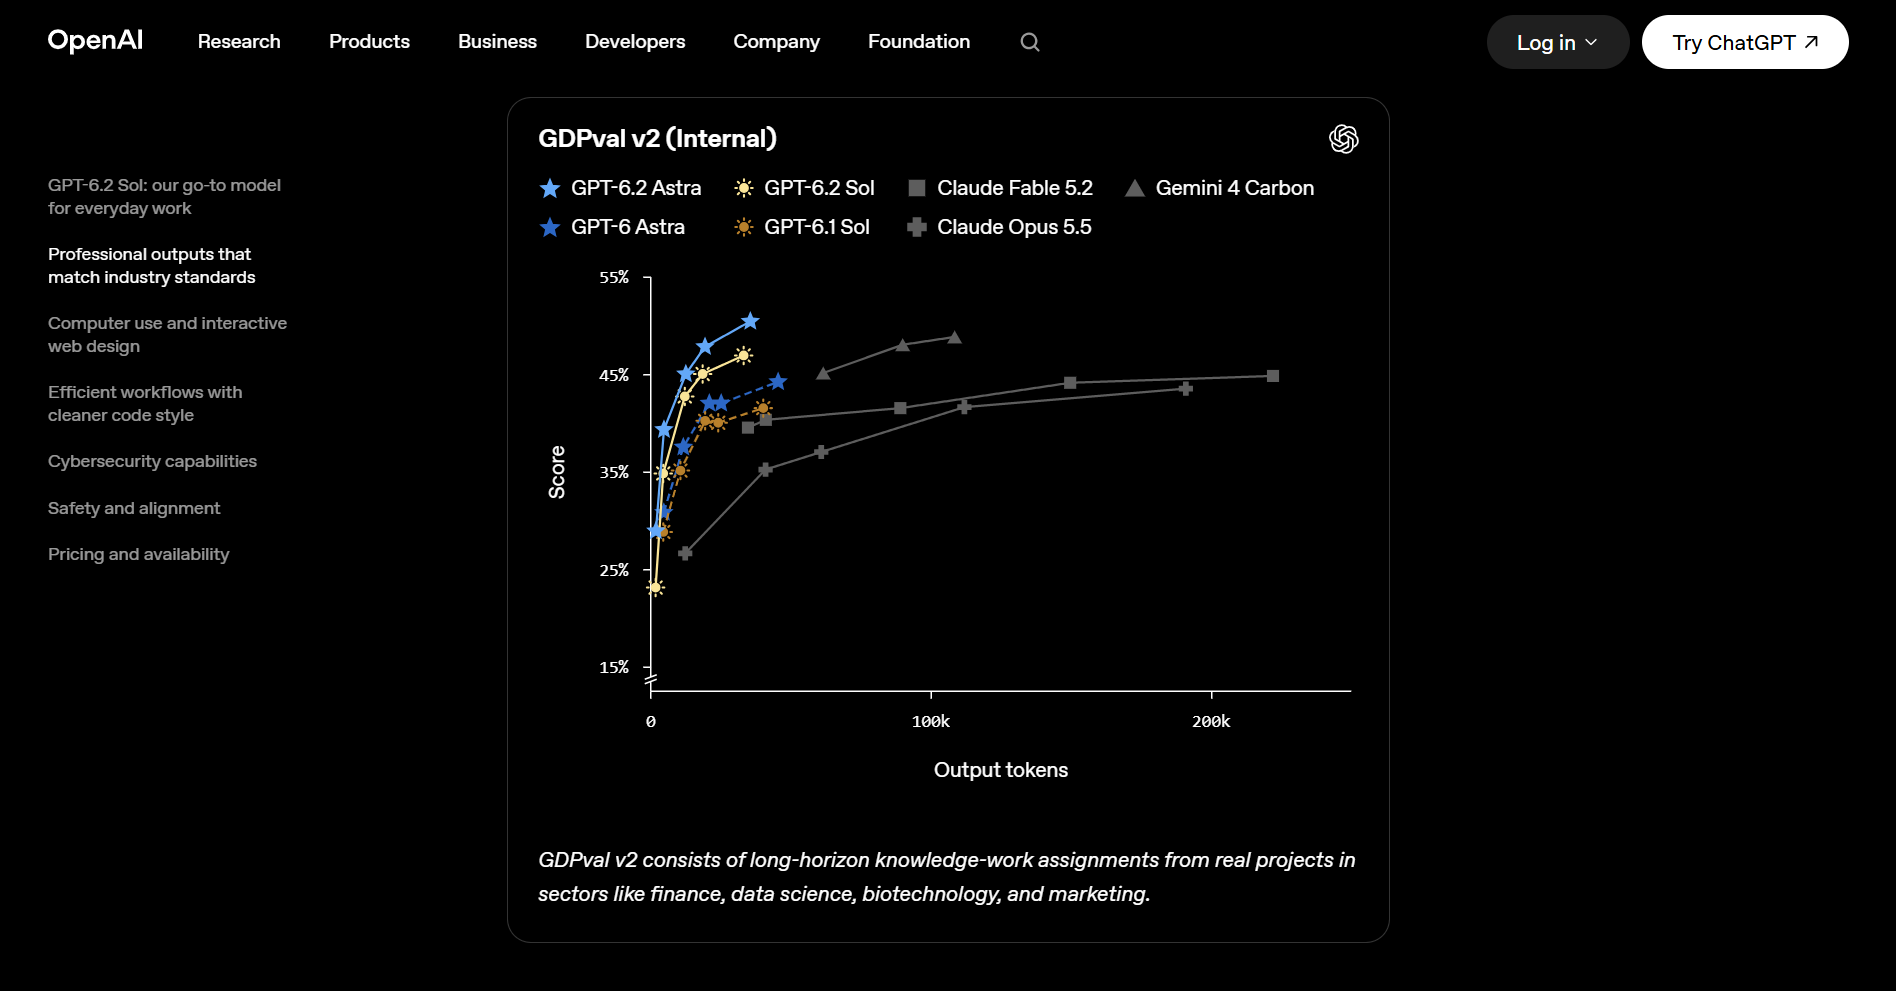
从这些结果可以看出,Astra 在复杂专业工作和科学研究方面表现突出;Sol 则在编程任务中展现出较高的性价比。两款模型并非所有任务都存在明显差距,具体表现仍取决于任务类型和测试条件。实际选型时,可以参考以下方向:
- 专业分析与科学研究:优先考虑 Astra,适合复杂数据分析、专业报告和多步骤研究任务
- 日常办公与高频调用:优先考虑 Sol,适合资料整理、内容生成和常规自动化流程
- 编程与 Agent 开发:常规代码开发可先使用 Sol;涉及复杂代码库修改或高难度任务时,再考虑 Astra
四、GPT-6.2 Astra 和 Sol 使用指南
1. 根据任务选择模型
选择模型时,不必所有任务都使用 Astra。日常内容写作、资料整理、代码调试和常规自动化,可以优先使用 Sol;涉及多文件分析、复杂代码库修改、专业报告生成或科学研究时,再考虑 Astra。
企业团队建议可以采用分级调用策略:默认由 Sol 处理常规任务,遇到复杂推理或高难度任务时,再切换到 Astra。这样既能满足不同任务的处理需求,也能控制 API 调用成本。
2. 保持稳定网络使用环境
对于需要长期调用AI的重度用户,尤其是运行 AI Agent 或自动化工作流时,网络波动可能导致请求超时、响应中断,影响任务连续执行。这类问题也可能与服务状态、请求限流或接口配置有关,需要先排查具体原因。
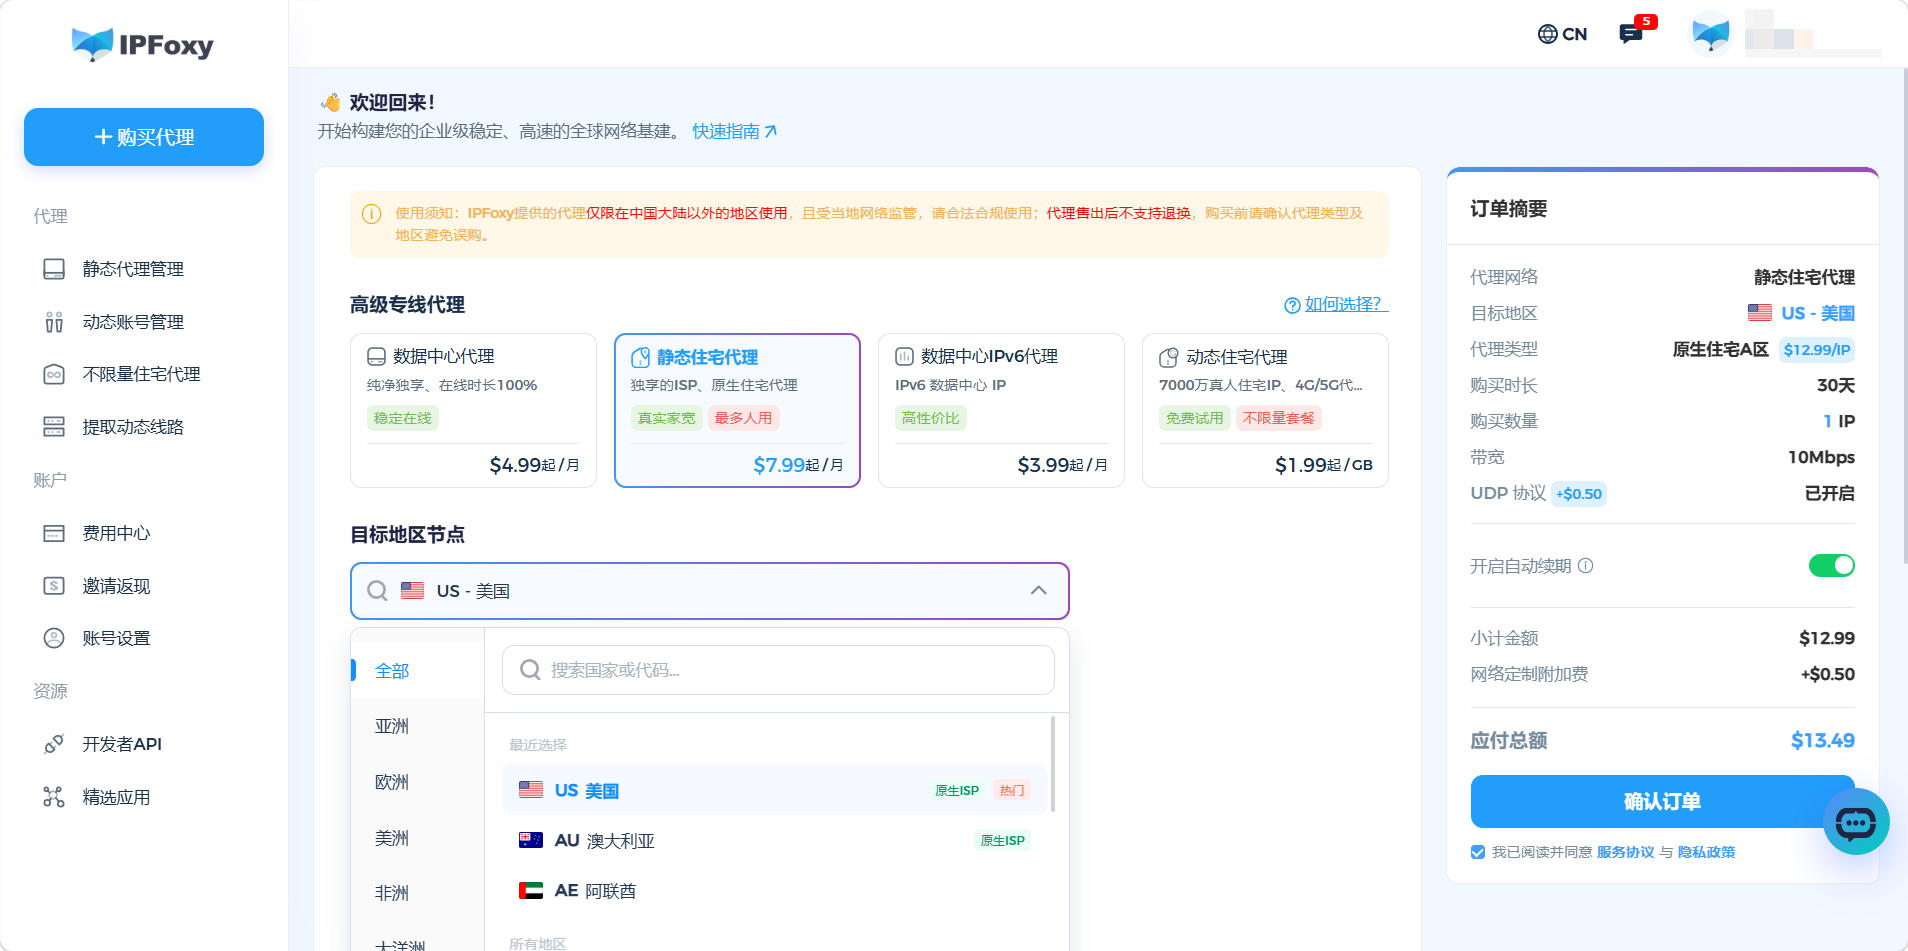
如果排查是网络出口的问题,建议使用稳定独享的代理IP资源,比如将IPFoxy的ISP住宅代理配置到你的设备上,这类IP来自可用地区的本土ISP,相对于免费/共享的网络出口,更加稳定真实且不易风控,减少任务连接中断与AI降智的风险可能。
3. 优化提示词与 Token 成本
调用API时,尽量保持系统提示词和任务前缀稳定,将变化的任务内容放在后面,有助于提高 Prompt Cache 命中率,减少重复输入带来的费用和延迟。
对于长程 Agent 任务,建议在提示词中明确执行目标、可调用工具、操作范围和最终交付格式,并设置阶段性检查。例如,要求 Agent 每完成一个阶段就汇报执行结果;遇到文件缺失或工具调用失败时,先说明原因,不要直接输出未完成的结果。
五、FAQ
1. GPT-6.2 Astra 和 Sol 可以在普通 ChatGPT 对话中使用吗?
目前,两款模型主要面向符合条件的 ChatGPT Work 和 Codex 用户开放,普通 Chat 对话暂不支持直接选择。
2. 如何在 Codex 中使用 GPT-6.2 Astra 和 Sol?
更新 Codex 至 0.166.0 或更高版本,在模型选择器中查找对应模型即可,具体取决于账号权限。
3. 使用 Codex 和 API Key 调用模型有什么区别?
使用 ChatGPT 账号登录 Codex,消耗订阅计划额度;使用 API Key 则按照 API Token 用量单独计费。
六、总结
GPT-6.2 Astra 和 Sol 并非简单的高低配关系,而是面向不同任务需求的两款模型。Astra 侧重复杂推理与专业任务,Sol 更注重日常效率和调用成本。实际应用中,应结合任务难度、运行环境和预算灵活选择,并通过合理分配模型与优化 Token 使用,在任务质量和成本之间取得平衡。