Neo4j是图数据库,底层存储的是节点和节点之间的关系
以下几点注意:
底层直接存储节点和关系
不像MySQL一样数据之间关系需要通过新建一张表来联系两张表【大量 JOIN 拖慢性能】
在neo4j中:
关系(Relationship)是独立、一等的存储对象,磁盘上单独存,自带双向指针
遍历是导航式遍历:拿到张三节点,顺着它身上挂的关系链表直接 “摸到” 邻居
MySQL想顺着人找好友:
必须通过
user_id去匹配、JOIN 这张表;找好友的好友,再一次 JOIN
满足ACID事务
| ACID 特性 | MySQL InnoDB | Neo4j | ||
|---|---|---|---|---|
| A 原子性 Atomic | undo log(回滚日志) | 事务逻辑日志(Logical Transaction Log)+ 写时拷贝(Copy-On-Write) | ||
| I 隔离性 Isolation | MVCC + 行级锁 + 间隙锁 (Gap Lock) | MVCC + 节点 / 关系粒度独占锁 + 快照隔离 | ||
| D 持久性Durability |
redo log(重做日志) | Transaction Log(事务日志,TxLog,等价 redo) | ||
| C 一致性 Consistency | 约束 + A+I+D 三者共同保障 | 图约束 + A+I+D 三者共同保障 |
它适合关联密集型查询(eg.好友关系、资金链路、知识图谱、依赖链路...)
支持集群高可用
查询命令的语言我们称之为Cypher
核心概念
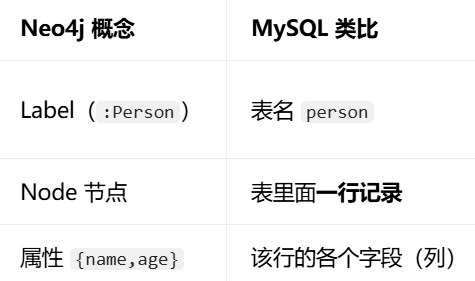
1.节点 Node
即图中的实体,用()表示,相当于MySQL 的一行数据,包括:
- Label(标签):节点分类,类似表名;一个节点可以多个标签
- Property(属性):key-value,节点字段
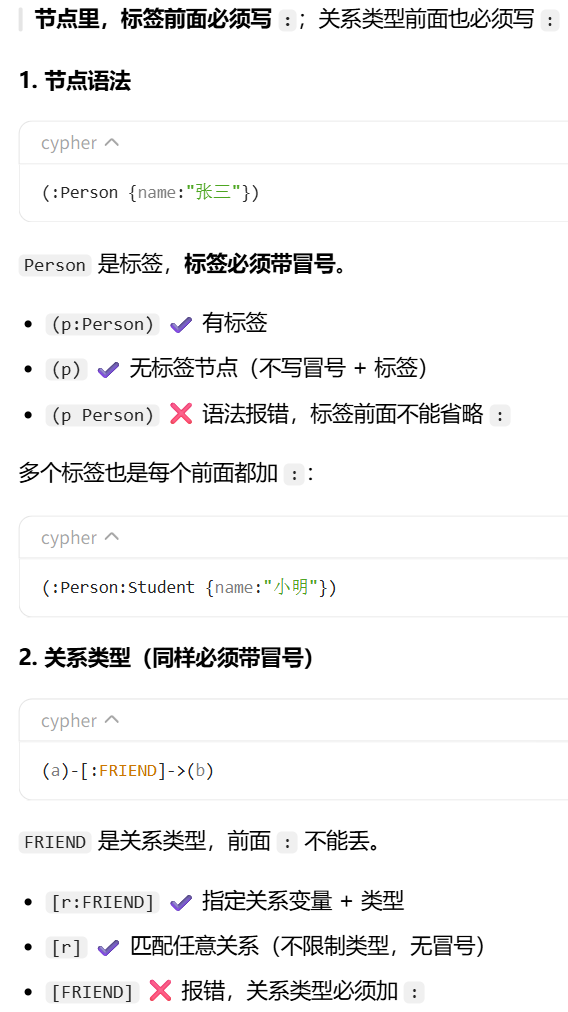
例如:(冒号就是标签(比如这里Person)前必带的符号)
(:Person {name:"张三", age:22})
但不完全一样:一个节点可以打多个Label,而MySQL 一行记录只能属于一张表
Label 只是分类标记,没有表结构约束
2.关系 Relationship
连接两个节点,有方向、有类型,用 -[]-> 表示,关系也可以带属性
- 关系类型 Type:比如
FRIEND、ACTED_IN、BELONG_TO - 方向:
->有向、--无向匹配
例如:
(张三)-[:FRIEND {since:2024}]->(李四)
3.路径 Path
节点 + 关系串起来的一条链路:A->B->C
其他
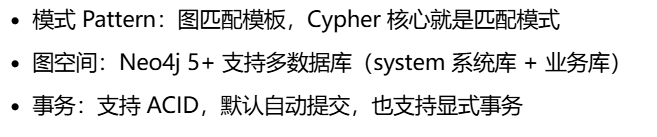
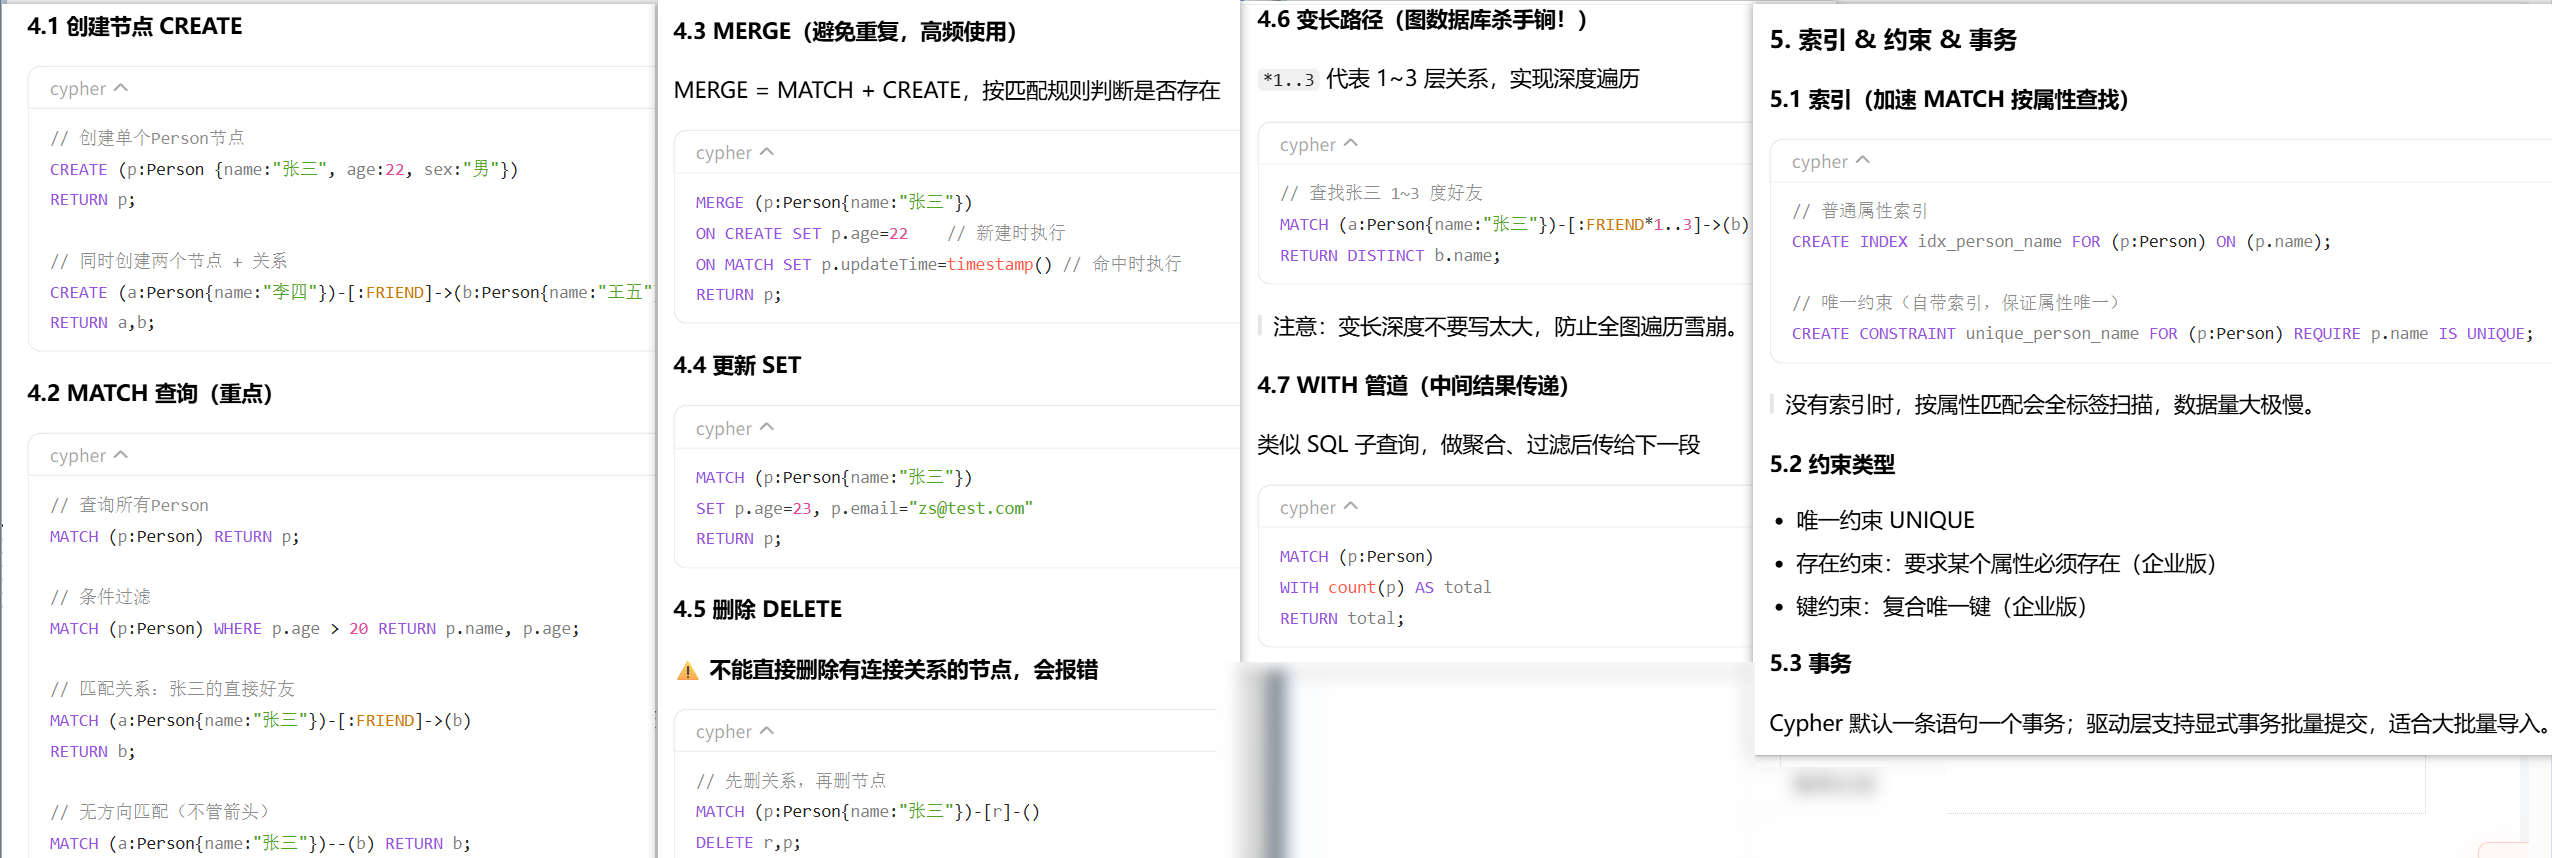
Cypher 查询语言
基础语法速览:
| 关键字 | 作用 |
|---|---|
MATCH |
匹配图模式(最核心) |
CREATE |
创建节点 / 关系 |
MERGE |
存在则匹配,不存在则创建(upsert) |
WHERE |
过滤条件 |
RETURN |
返回结果 |
SET |
修改属性、添加标签 |
DELETE |
删除节点 / 关系(删节点前要先删关联关系) |
REMOVE |
删除属性、标签 |
ORDER BY / SKIP / LIMIT |
排序分页 |
注意区分关系和Cypher语言:
关系是我们自己定的可以随心写
关于冒号:
可以下面自己了解一下实际开发中比如要引入什么依赖、要怎么提前做好数据库的连接、存数据时用不用像MySQL一样写好对应的类对应好数据库中的字段...