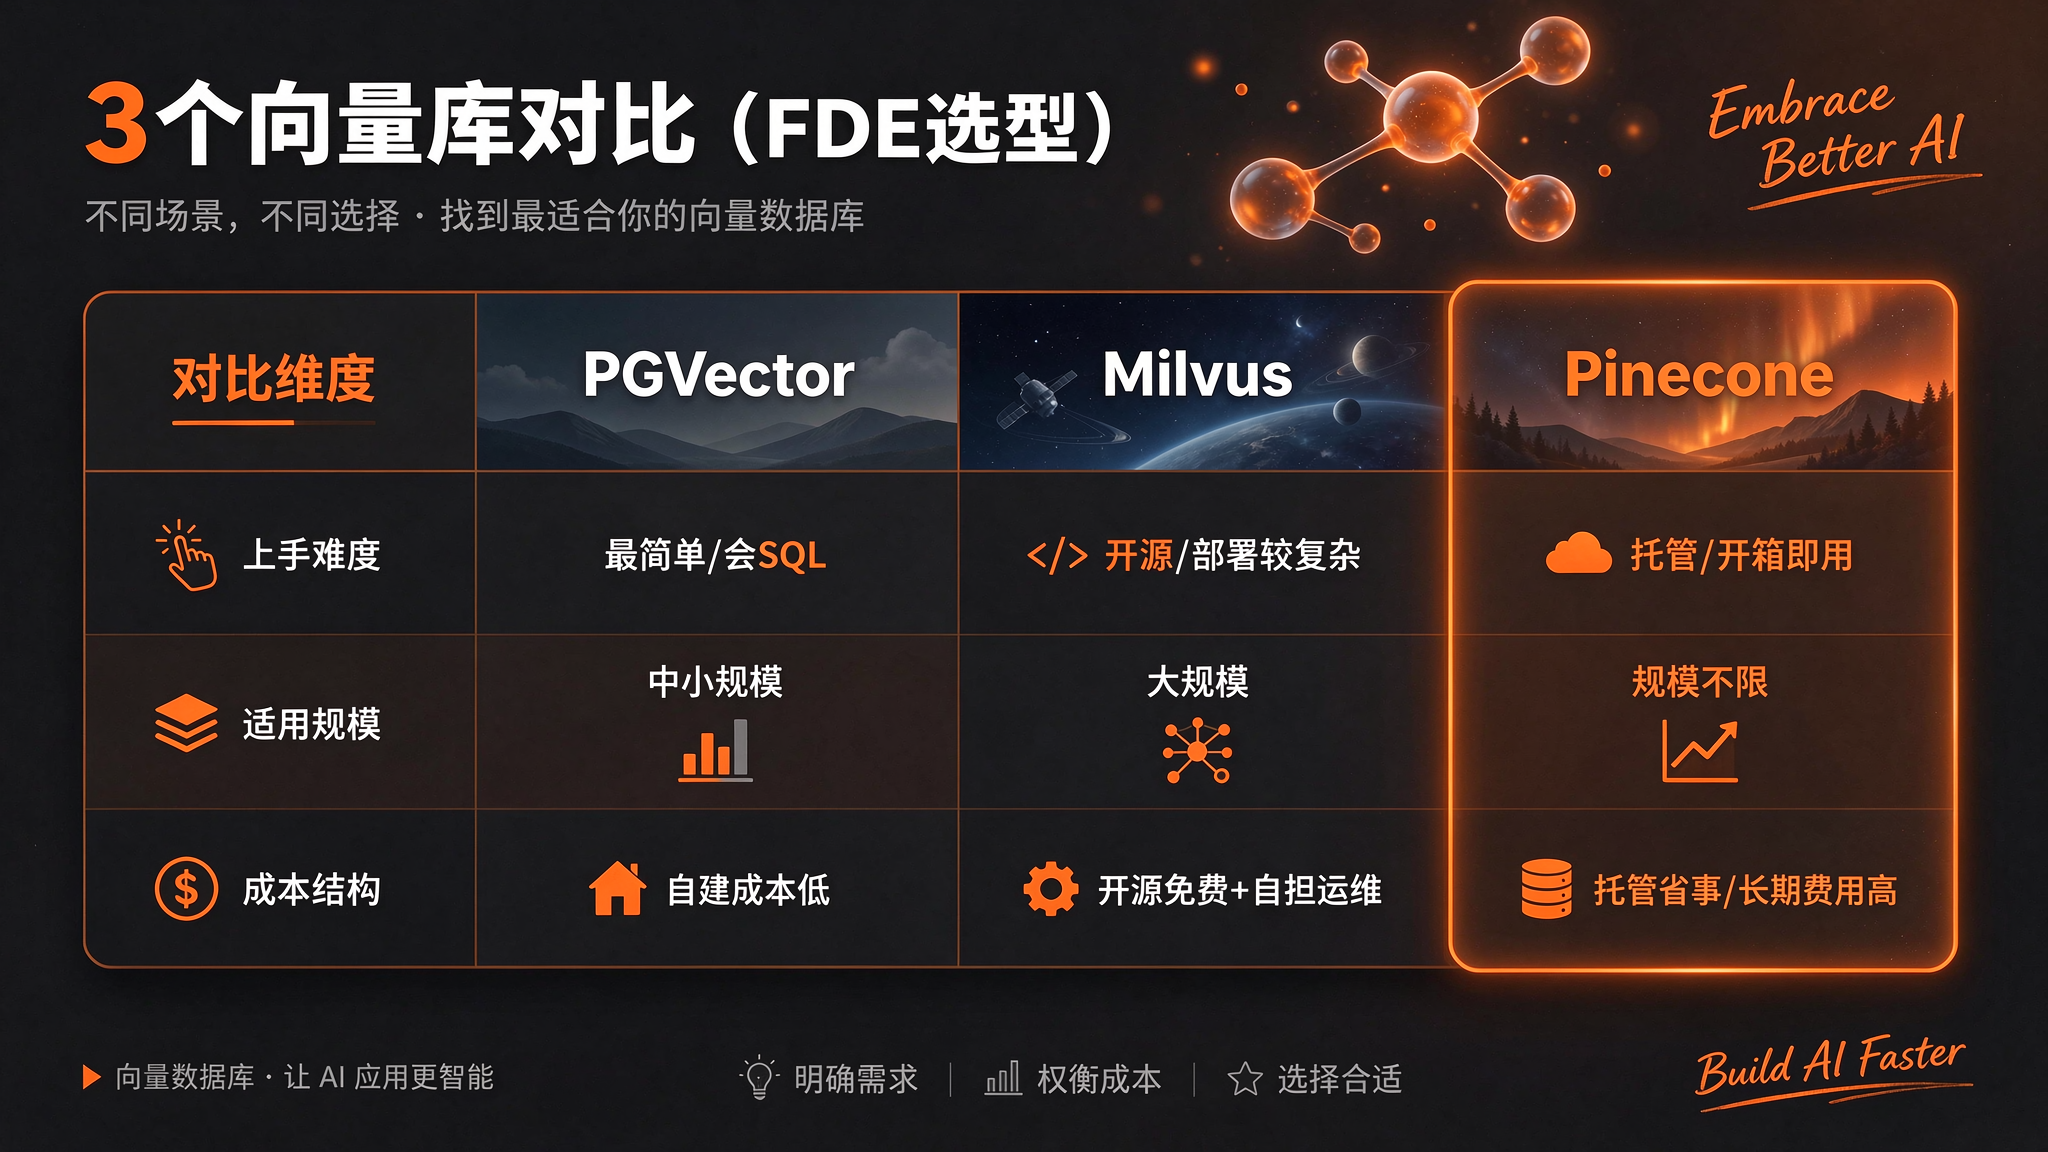
搭 RAG,向量数据库选哪个?PGVector、Pinecone、Milvus,新手经常纠结。这篇按上手难度、数据规模、成本、FDE 常用选择逻辑几个维度对比清楚。 核心结论先放前面:不是功能越强越好,是匹配项目阶段和客户现状。demo 阶段用最简单的快速跑通,生产阶段再按规模和要求选。向量库是工具,能把 RAG 跑起来比追求最强功能更重要。
维度 1:上手难度
三个选项的上手门槛差别比较明显。
PGVector:基于 PostgreSQL 的扩展,会 SQL、用过 Postgres 就能用,上手最简单。数据库表结构、查询方式都和熟悉的关系库一致,学习成本低。
Pinecone:托管服务,开箱即用,不用自己部署维护集群;但需要申请账号、联网调用,数据走外部服务。
Milvus:开源向量数据库,能力强,但部署和运维相对复杂,需要理解自己的集群和组件。
怎么选?新手和小项目优先 PGVector,复用已有数据库经验,最快把链路跑通;想省事、不想管部署的可以考虑托管;有大规模和运维能力再上 Milvus。
维度 2:适用数据规模
不同向量库适合的数据量区间不一样。
PGVector:适合中小规模,几万到几十万条向量的量级基本够用;数据量再往上,性能和检索效率会逐步吃紧。
Milvus:适合大规模场景,百万条以上量级性能更强,是为海量向量检索设计的。
Pinecone:托管服务,规模由平台承载,不需要自己操心扩容,按量使用。
怎么选?数据量小、先验证想法,用 PGVector;明确要做大规模、高性能检索,考虑 Milvus;不想自己评估容量和扩容,用托管服务。实际选型时最好用自己的数据量级做一轮检索测试,看响应速度是否达标。
维度 3:成本对比
成本结构三者不同,不能只看表面单价。
PGVector:自建成本低,能复用现有 Postgres 实例,不需要额外引入一套数据库;主要成本在已有数据库资源上。
Milvus:开源免费,但要自己承担服务器资源和运维投入;规模越大,硬件和维护成本越高。
Pinecone:托管省事,不用运维,但长期使用按用量付费,费用通常比自建国高。
怎么选?预算有限、团队有运维能力,选自建路线;想省事、快速上线、不想管基础设施,选托管。成本要把"软件 + 服务器 + 人力运维 + 长期用量"一起算,而不是只比软件价格。具体定价以各家官方当时口径为准。
维度 4:FDE 常用选择逻辑
结合 FDE 项目的典型阶段,选型可以按场景对号入座。
客户 demo / 小项目:PGVector 最快出活,链路简单、部署快,适合先验证想法。
客户已有 Postgres:优先 PGVector,不引入新组件,架构和运维都更轻。
大规模 / 高性能要求:选 Milvus,检索性能和扩展性更匹配。
不想运维 / 快速上线:选 Pinecone 这类托管服务,把精力放在应用本身。
核心逻辑:不是功能越强越好,是匹配项目阶段和客户现状。demo 阶段没必要上重型集群,生产阶段再根据规模、性能和合规要求升级。
向量库选型的核心是什么?
总结一下:向量库选型,先看数据规模,再看团队运维能力,最后看预算。
demo 阶段:用最简单的,快速跑通;生产阶段:按规模和要求选。
还有一点容易被忽略:向量库是可以迁移的。初期用轻量方案跑通,后续数据量上来再换更强的库,不必一开始就押注最复杂的方案。选型时也把"后续好不好迁移"考虑进去。
最后提醒:无论选哪个,RAG 效果不只是向量库决定的。文档切分、检索策略、Prompt 质量同样关键。先把整套链路跑起来,再根据真实数据和反馈优化组件,比一开始纠结哪个库最强更实际。
你现在用哪个向量库?遇到过什么问题?评论区聊聊。